口播手势
把一段讲话表演迁移到静态人物图
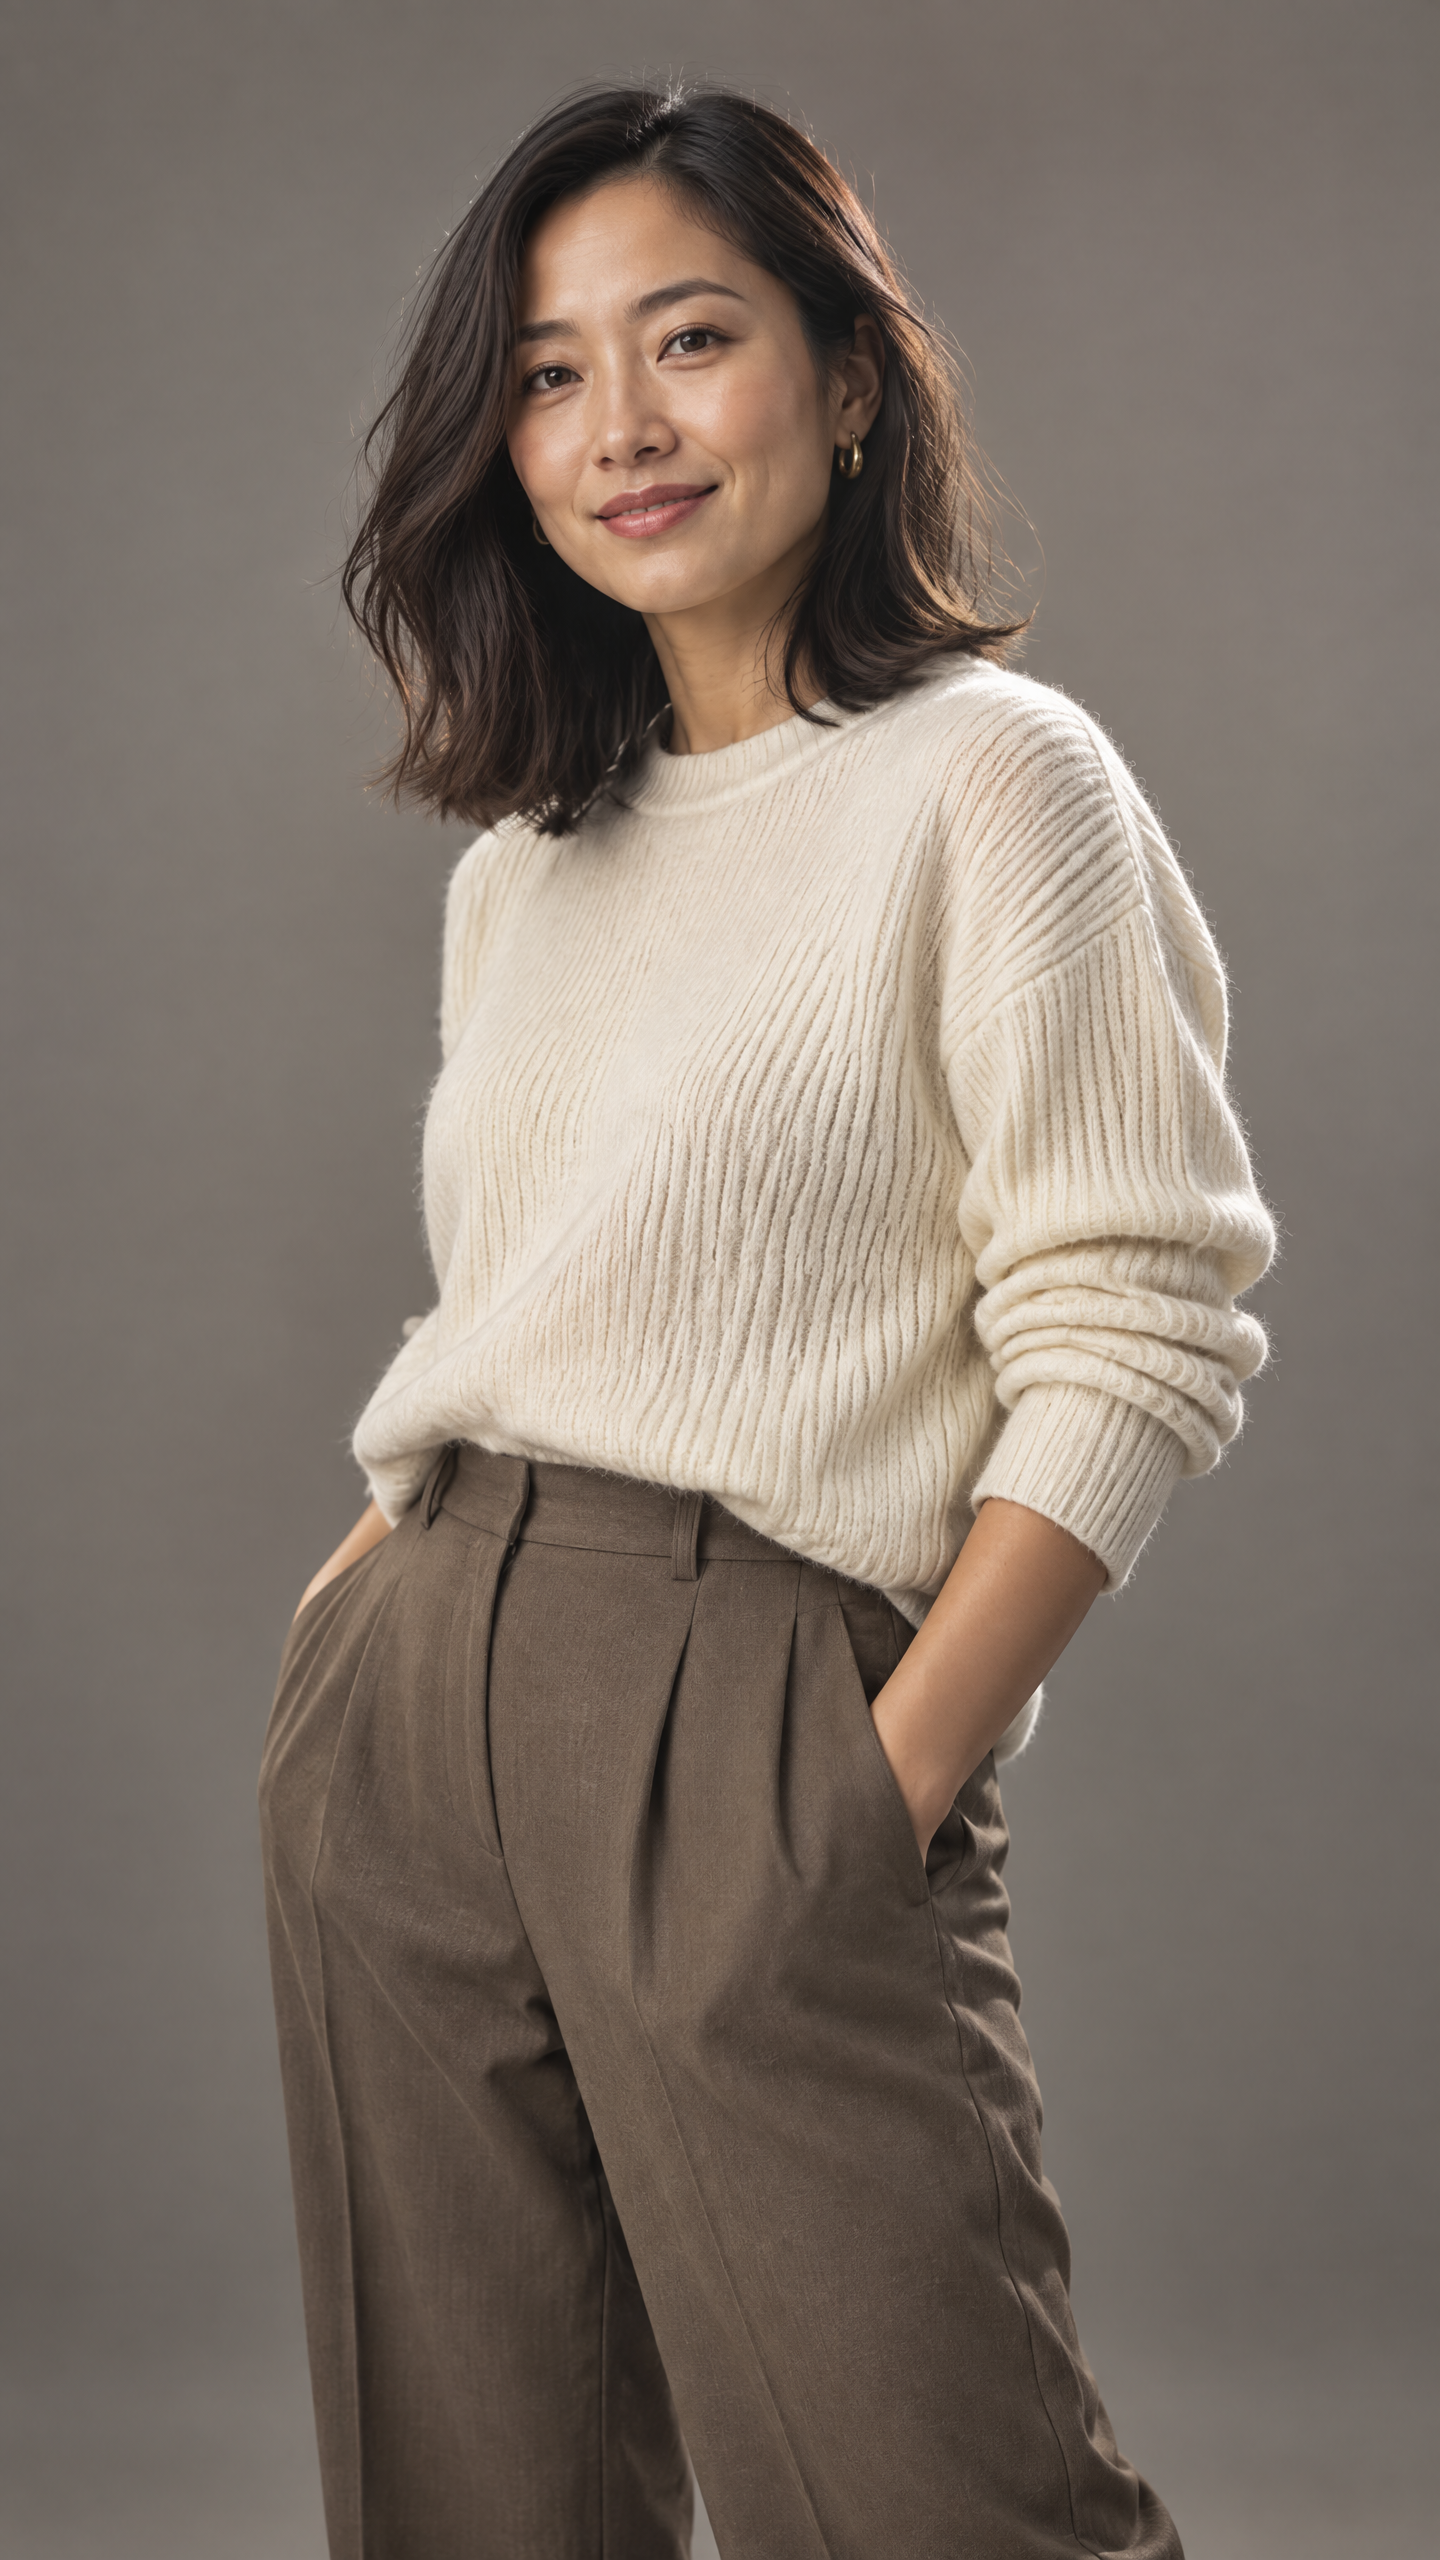
人物图提供身份与服装,参考视频提供口型、手势与语气。输出保留毛衣和面部特征,节奏跟随参考视频,并沿用原声音轨。
6s1080p朝向:跟随视频保留原声
Prompt
The woman presents directly to camera in a warm studio, steady framing, natural expression
女子在暖调影棚里正对镜头讲述,机位稳定,表情自然
Kling 3.0 Motion Control API:上传一张人物图和一段 3-30 秒动作参考视频,把动作、表情与原声一起迁移到图中人物,适合舞蹈翻跳与数字人口播,可在线试用并查看实时价格。
提供商: Kuaishou
类型: 视频生成
接口: /v1/tasks
状态: 已开放
消耗: 查看页面实时价格
Kling 3.0 Motion Control API:上传一张人物图和一段 3-30 秒动作参考视频,把动作、表情与原声一起迁移到图中人物,适合舞蹈翻跳与数字人口播,可在线试用并查看实时价格。
定价
标准用量
准备生成
配置参数并点击"运行"查看输出结果。
真实 API 生成结果
每组示例都是通过 HiAPI 调用本模型的真实结果:输入一张人物参考图和一段动作参考视频,输出一段身份来自图片、动作与原声来自视频的 AI 视频。
口播手势
人物图提供身份与服装,参考视频提供口型、手势与语气。输出保留毛衣和面部特征,节奏跟随参考视频,并沿用原声音轨。
Prompt
The woman presents directly to camera in a warm studio, steady framing, natural expression
女子在暖调影棚里正对镜头讲述,机位稳定,表情自然
舞蹈翻跳
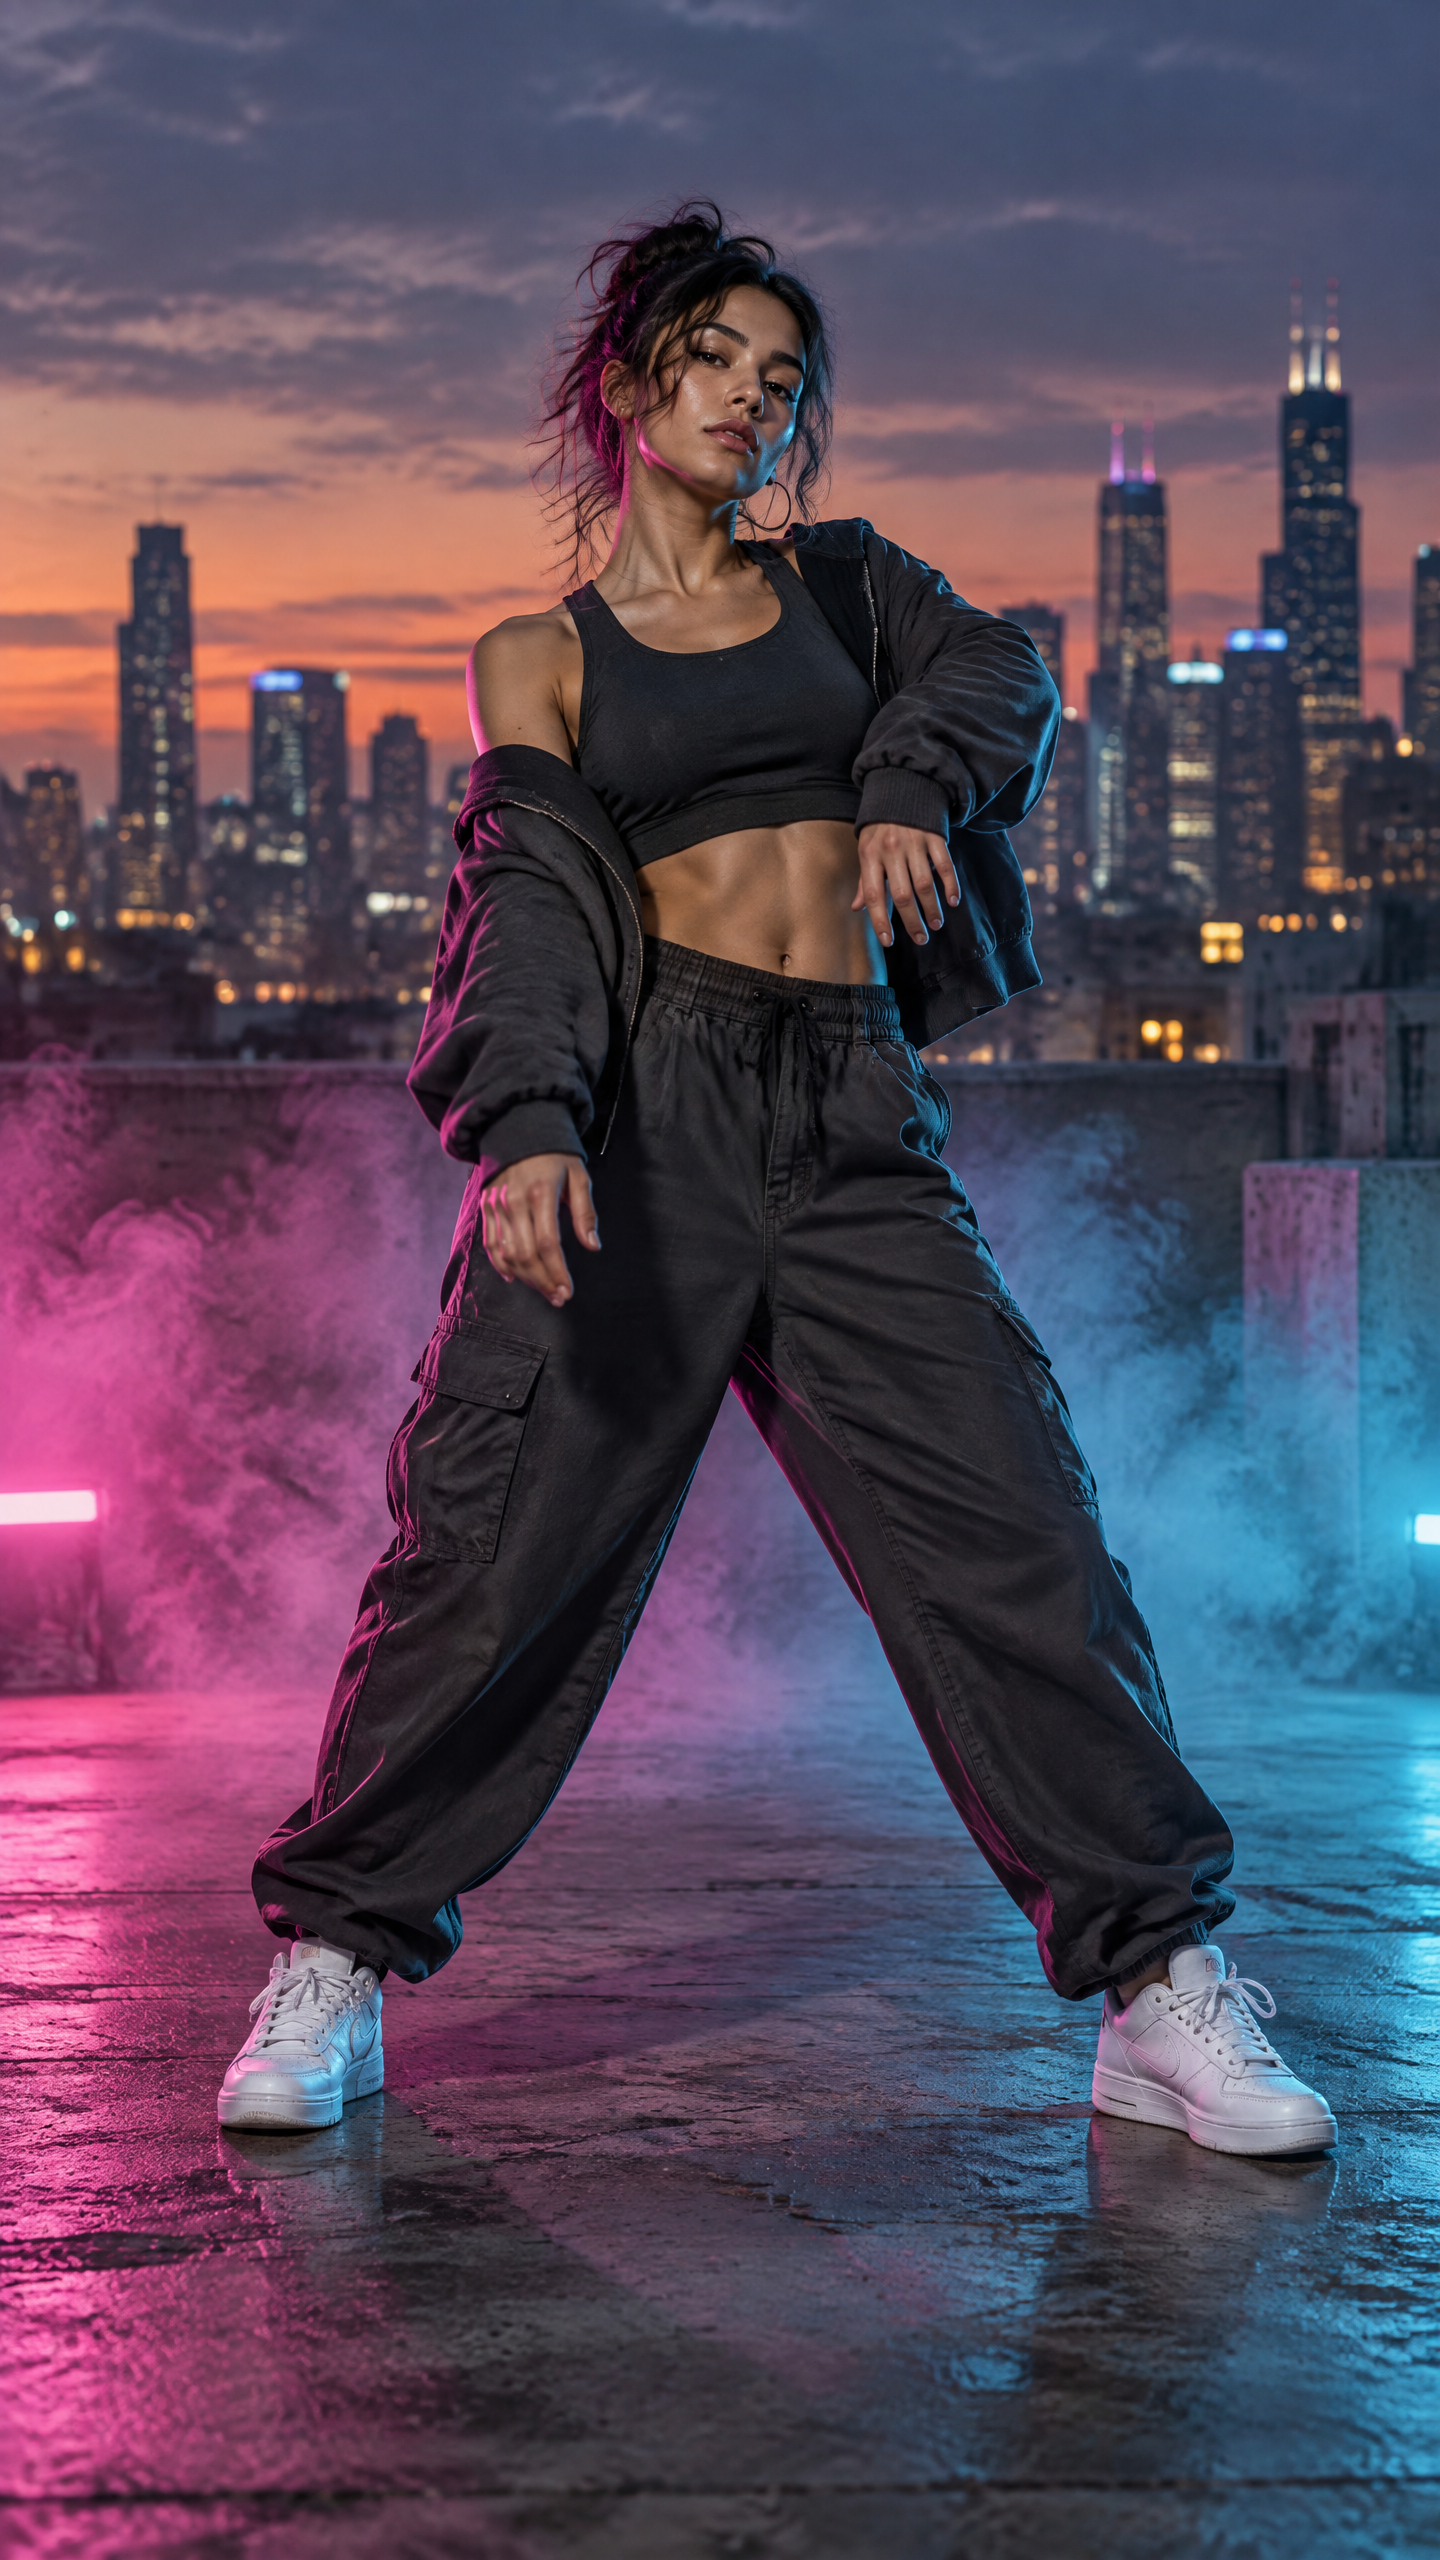
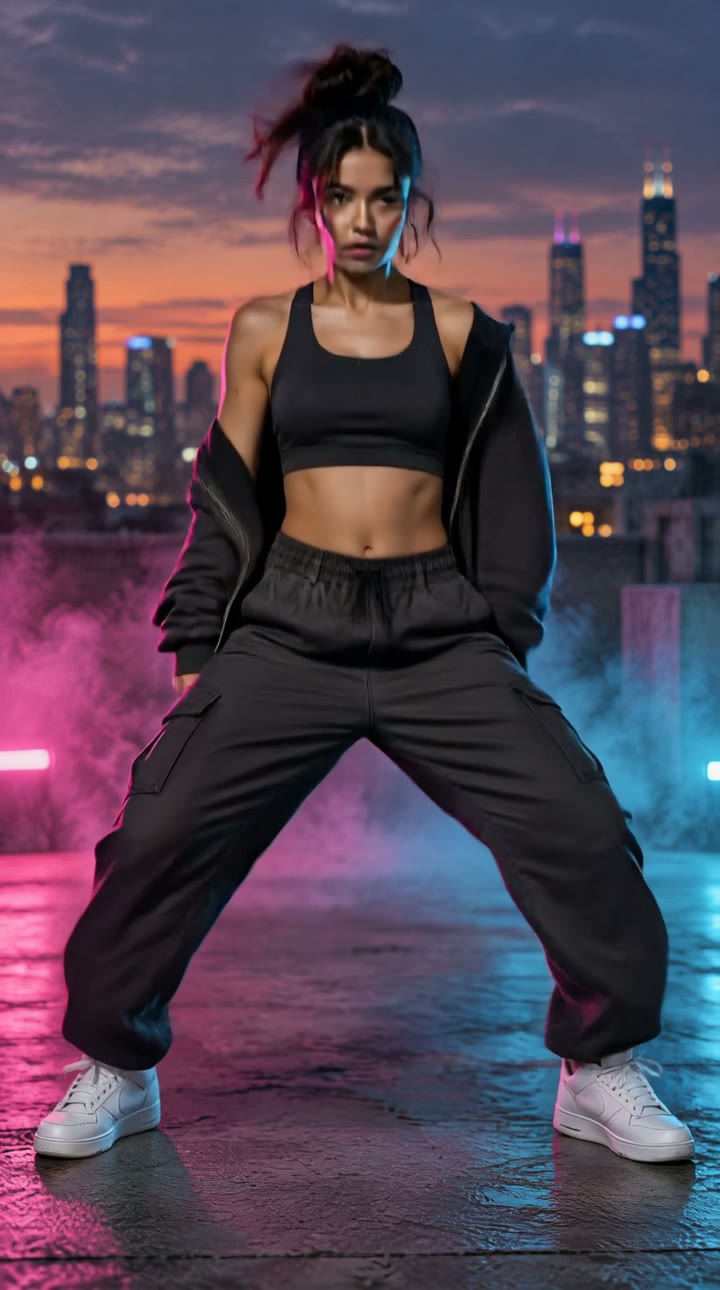
大幅度、多方向的连续动作与快速脚步:身份与服装跟随参考图,节奏、节拍与环境声跟随参考视频。这条链路使用 video 朝向,可容纳更长的参考素材。
Prompt
The dancer performs the street groove on the rooftop at dusk, camera steady, keep the outfit and city backdrop
舞者在黄昏的屋顶跳街舞,机位稳定,保留服装与城市背景
讲解口播
character_orientation=image 让人物朝向跟随参考图,讲解过程中不会转身离开镜头。这条链路适合课程、产品演示与固定机位口播。
Prompt
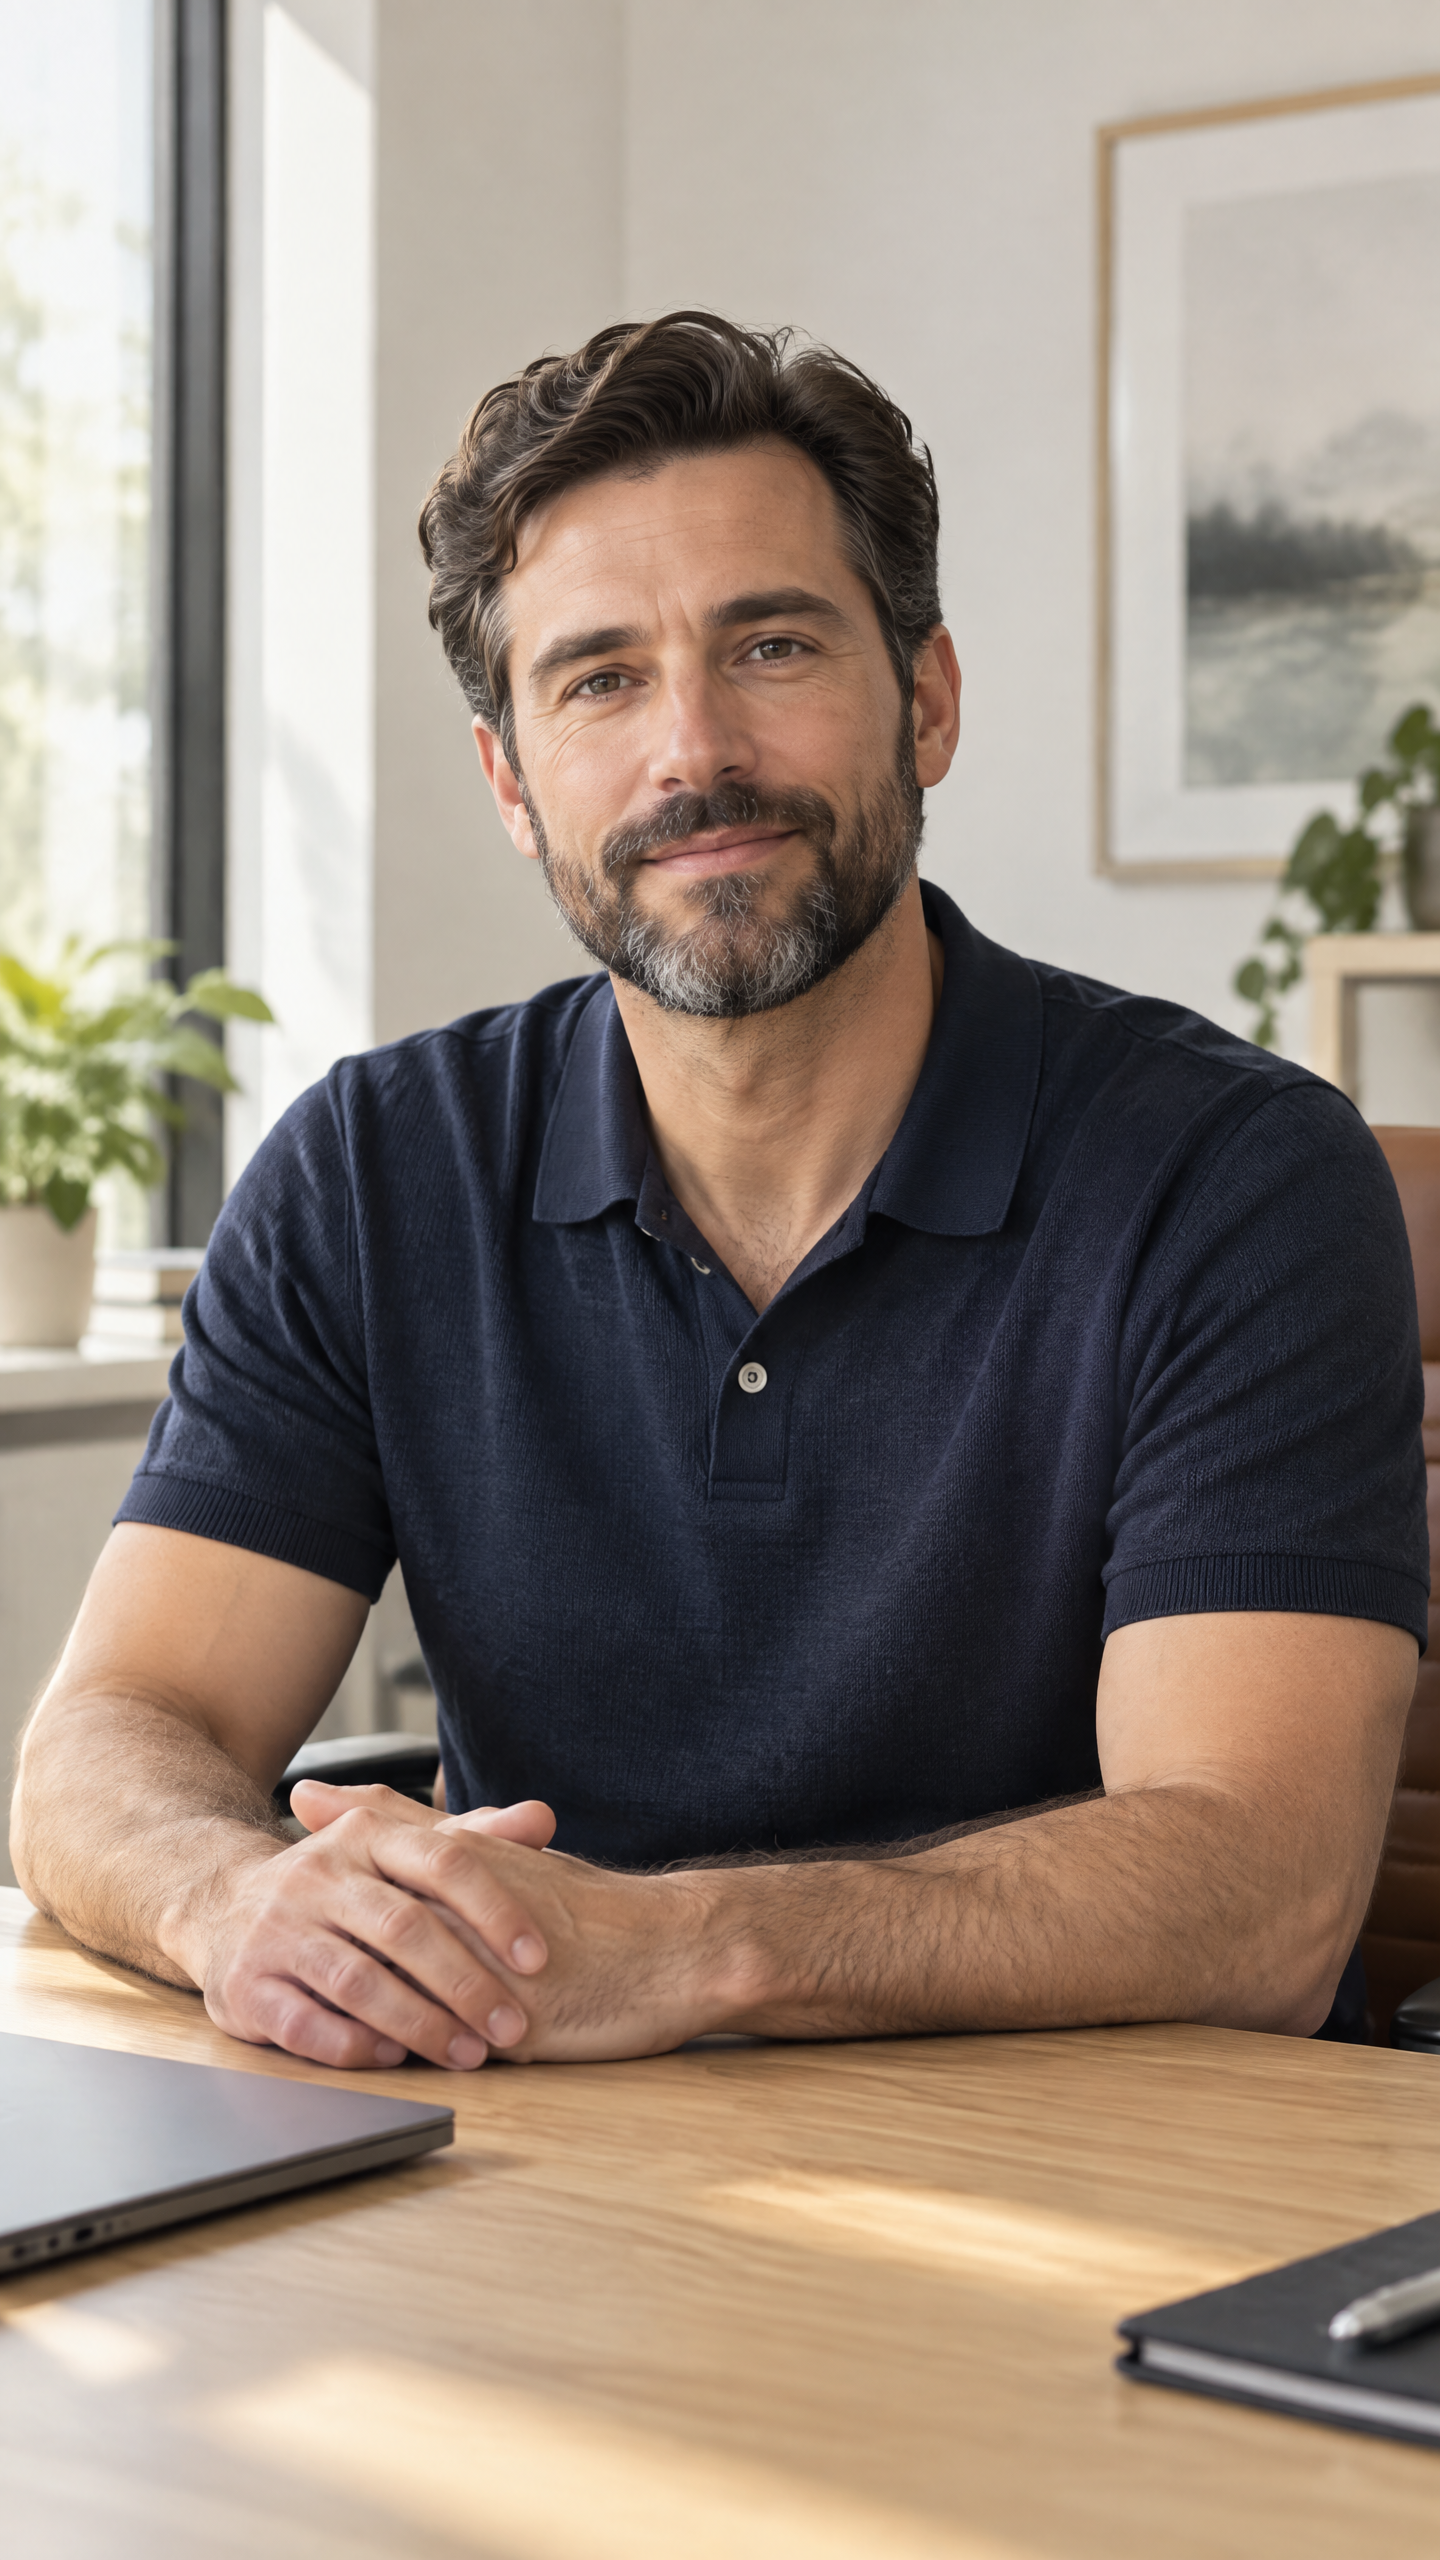
The man explains at his desk in the bright office, camera holds his orientation from the photo, calm delivery
男子在明亮的办公室里对着镜头讲解,机位保持照片中的朝向,语气平稳
只有静态图想让它动、要多段参考素材合成新镜头、或者要脚本驱动的数字人时,HiAPI 上还有这些视频生成 API 可选。
Kling 3.0 Motion Control 是快手可灵(Kling AI)3.0 系列的动作控制模型,也是一种带动作参考的图生视频(image-to-video with motion reference):上传一张人物参考图和一段动作参考视频,图片决定人物长相与服装,视频决定动作、表情与节奏,输出一段以图中人物为主角、复刻参考动作的 AI 视频,不需要再写动作提示词。
相比 Kling 2.6 Motion Control,3.0 在转头、遮挡后恢复和长动作段上的面部一致性更稳,输出可保留参考视频原声,适合 AI 舞蹈视频、数字人口播、品牌吉祥物动画和分镜预演这类“换人不换动作”的场景。
Playground 与 API 使用同一个模型 ID:kling-3.0/motion-control。character_orientation 决定人物朝向跟随视频还是图片,也决定输出时长上限;keep_original_sound 控制是否沿用参考视频的声音。
以下规格对应当前 HiAPI 请求契约:输入限制、输出时长、分辨率与按秒计费的价格,任务完成后按实际输出时长结算。
人物参考图
动作参考视频
输出时长
输出分辨率
声音
模型 ID
接口
三步完成一次动作迁移视频生成:准备素材、选参数、提交任务。先用短片段和 720p 验证效果,再提高分辨率或换更长的参考视频。
人物图要正面露出头肩与躯干;动作视频 3–30 秒、单镜头、单人入镜、无遮挡。两者上传后填入 image_url 与 video_url。
大幅度或多角度动作选 video 朝向(≤30 秒);固定机位口播选 image 朝向(≤10 秒)。先用 720p 验证效果,再用 1080p 出成片;不需要原声时关闭 keep_original_sound。
通过 kling-3.0/motion-control 创建异步任务,用 callback.url 或轮询 GET /v1/tasks/:id 获取结果。费用按实际输出秒数结算,生成通常需要数分钟。
一个 POST /v1/tasks 请求即可提交动作迁移视频任务,cURL、Python、Node.js 示例可直接复制运行;完整参数、回调与错误处理见 API 文档。
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "kling-3.0/motion-control",
  "input": {
    "image_url": "https://static.hiapi.ai/model-examples/kling-3.0-motion-control/v3/2026/09/28/1790607181108-36686f5400675348-p1.png",
    "video_url": "https://static.hiapi.ai/model-examples/kling-3.0-motion-control/v3/2026/09/28/1790608051171-c882228bfe66fe03-c1.mp4",
    "resolution": "1080p",
    "character_orientation": "video",
    "keep_original_sound": true,
    "prompt": "The woman presents directly to camera in a warm studio, steady framing, natural expression"
  }
}'KLING 3.0 MOTION CONTROL API
Kling 3.0 Motion Control 是快手可灵 3.0 系列的动作控制(motion control)视频生成模型,把一段参考视频里的动作、表情和语气完整迁移到一张人物图上:图片决定这个人是谁、穿什么,视频决定他怎么动、怎么说话、什么节奏。两份素材交代清楚,剩下的交给模型,不需要再写动作提示词。
输出跟随参考视频的长度与节奏,自带原生音频:讲话口播直接沿用原音轨,舞蹈翻跳保留现场节拍,不需要后期配音对轨。人物身份贯穿全片,转头、抬手和短暂遮挡后仍能稳定恢复。
下面用同一批素材说明六项能力:动作迁移的身份与表演分工、同一角色换动作、同一动作换角色、character_orientation 两种朝向、keep_original_sound 原声迁移,以及参考素材的拍摄要求。所有示例都是通过 HiAPI 调用本模型的真实结果。
每一组都对应一个具体问题:谁出现在画面里、做什么动作、用什么机位、声音怎么办。素材来自同一批真实任务,可以直接对照。
01
人物图只负责身份信息:脸型、发型、Polo 衫的颜色和办公室背景。参考视频只负责表演:说话的节奏、转头与微笑的时机、手势的起伏。两者分开之后,同一个角色可以反复出演不同片段,而人物形象不会漂移。
这条链路同时也是生成顺序:先用图像模型产出人物图,再用视频模型基于该图生成表演参考,最后用本模型完成迁移。页面上的全部示例都按这个顺序生成。
一次录制讲稿,套用到多个形象或语言版本,原有语气与停顿随音轨保留。
把热门动作搬到自有角色身上,动作与节拍来自参考视频,形象来自图片。
固定一张角色设定图,让它在不同片段里保持同一张脸地动起来。
用低成本素材预演动作与节奏,确认后再上高分辨率或更长参考。
同族和同类模型分工不同,按手里的素材选:只有静态图、要多段素材合成新镜头、或者要脚本驱动的数字人,都有更合适的模型。
Kling 3.0 Motion Control
手里有一张人物图和一段真实表演视频,要把这段表演迁移过去。
Kling 3.0 图生视频
只有静态图,想让它按提示词自然地动起来,不需要参考表演。
Seedance 2.5 参考生视频
要多段图片、视频或音频共同合成一个全新镜头,而不是复刻单一表演。
HeyGen Avatar V
画面由脚本和语音合成驱动,需要标准化的数字人播报。
同一个 API Key 覆盖 Playground 与线上调用:先在页面里试出满意的素材组合,再把同一份请求体搬进服务端,不用换账号或换接口。任务异步提交,可以用回调接收终态,也可以用查询接口补偿。
计费按实际输出秒数结算:创建任务时按朝向上限预扣额度,生成完成后按真实时长多退少补,参考素材本身不额外计费。产物由平台托管,可以直接下载或接入自己的存储流程。
视频、图片、音频模型共用一份凭据与用量视图。
预扣按上限,完成后按实际输出秒数调整。
示例素材与黄金产物的原始文件可下载核对。
两项必填:一张人物参考图(image_url)和一段 3-30 秒的动作参考视频(video_url)。人物图决定外观与身份,参考视频决定动作、表情与节奏。Prompt 可选,用来补充场景、风格和运镜。
不需要传时长。输出跟随参考视频长度:character_orientation=video 时最长 30 秒,image 时最长 10 秒。动作过快或过复杂时,模型只提取可用动作段,输出可能短于参考视频。
video:人物朝向跟随参考视频,适合舞蹈、走位等大幅度或多角度动作。image:人物朝向跟随参考图,适合固定机位加运镜的口播、讲解类内容,输出最长 10 秒。
mp4/mov,最大 100MB,3-30 秒,单镜头连续拍摄,人物头部、肩部与躯干清晰可见,尽量单人入镜、避免频繁切镜和遮挡。参考图同样需要露出头肩与躯干,双边大于 340px,宽高比在 2:5 到 5:2 之间。
默认保留(keep_original_sound=true),适合口播和舞蹈翻跳直接沿用原音轨;不需要时传 false 只输出画面。
按实际输出秒数计费,720p 与 1080p 单价不同。任务创建时按朝向上限预扣,完成后按实际输出秒数多退少补;具体单价见本页实时价格区。
02
换动作只需要换参考视频。人物图保持不变,街舞参考视频把同一张脸带进完全不同的动作幅度和场景节奏里,衣服、发型和五官保持一致,适合做同一角色的系列内容。
03
反过来也成立:参考视频不动,替换人物图就能让另一个人完成同样的讲话与手势。同一支口播素材可以套用到多个形象上,用于换人重制、角色分身或多语言配音的画面部分。
04
character_orientation=video 让人物朝向跟随参考视频,适合舞蹈、走位和大范围动作,输出最长 30 秒;character_orientation=image 让人物保持照片里的朝向,机位更稳,适合固定机位的讲解和口播,最长 10 秒。
同一段动作素材在两种模式下的取舍不同:跟随视频能容纳更复杂的动作,跟随图片则更适合产品演示、课程讲解这类不允许人物乱转的场景。
05
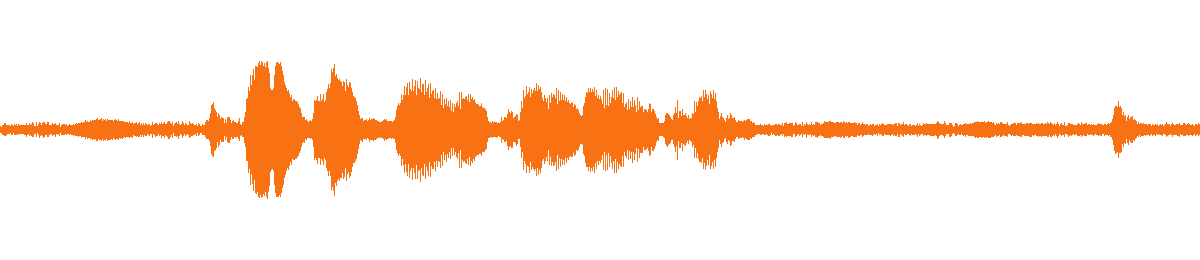
keep_original_sound 默认开启,参考视频的音轨会原样进入输出:口播的语气、停顿和气口都不需要重新录,舞蹈片段保留现场节拍,成片可以直接剪辑或加字幕。
下方波形取自示例输出本身的音轨,可以看到讲话段落的能量分布。不需要原声时把参数设为 false,输出只保留画面。
06
参考视频要求 mp4/mov、最大 100MB、3-30 秒、单镜头连续拍摄,人物头部、肩部与躯干清晰可见,尽量单人入镜、避免频繁切镜和遮挡。人物图同样要露出头肩与躯干,双边大于 340px,宽高比在 2:5 到 5:2 之间。
动作幅度过大或镜头切换频繁时,模型只提取可用的动作段,输出可能短于参考视频;这也是时长结算按实际输出秒数计算的原因。