把一张首帧图变成 3-16 秒、最高 4K 的有声视频:画幅跟随图片,原生音频默认开启,按秒计费。

提供商: Vidu

类型: 视频生成

接口: /v1/tasks

状态: 已开放

消耗: 查看页面实时价格

返回模型列表

Vidu Q4 Preview Image-to-Video

提供商 Vidu视频

把一张首帧图变成 3-16 秒、最高 4K 的有声视频:画幅跟随图片,原生音频默认开启,按秒计费。

定价

标准用量

218 积分/ s

输入

首尾帧

用图片控制视频的开始和结束画面。

首帧必填
0 / 5000
预估费用1,375 积分275 积分 / s × 5s × 1080p

输出

准备生成

配置参数并点击"运行"查看输出结果。

--

从一张静帧到一段有声镜头

下面几组输入与成片都由首帧驱动,差别在画幅、音频开关和分辨率档位:有的保留原生音频,有的直接传入竖版首帧、不设任何比例参数,有的关掉音频、用 540p 做循环素材。每张卡片都标了实际时长、分辨率和画幅,提示词可以直接复制到 Playground 改写。

横屏 · 原生音频3s540p16:9

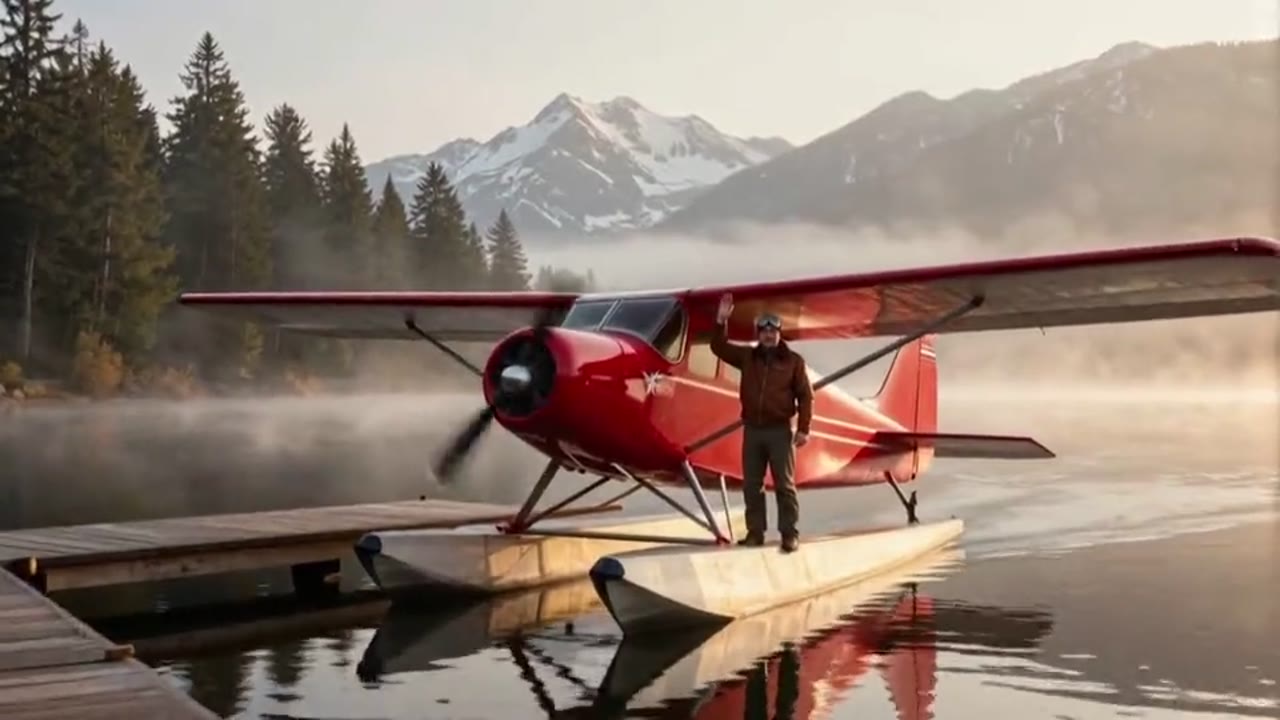
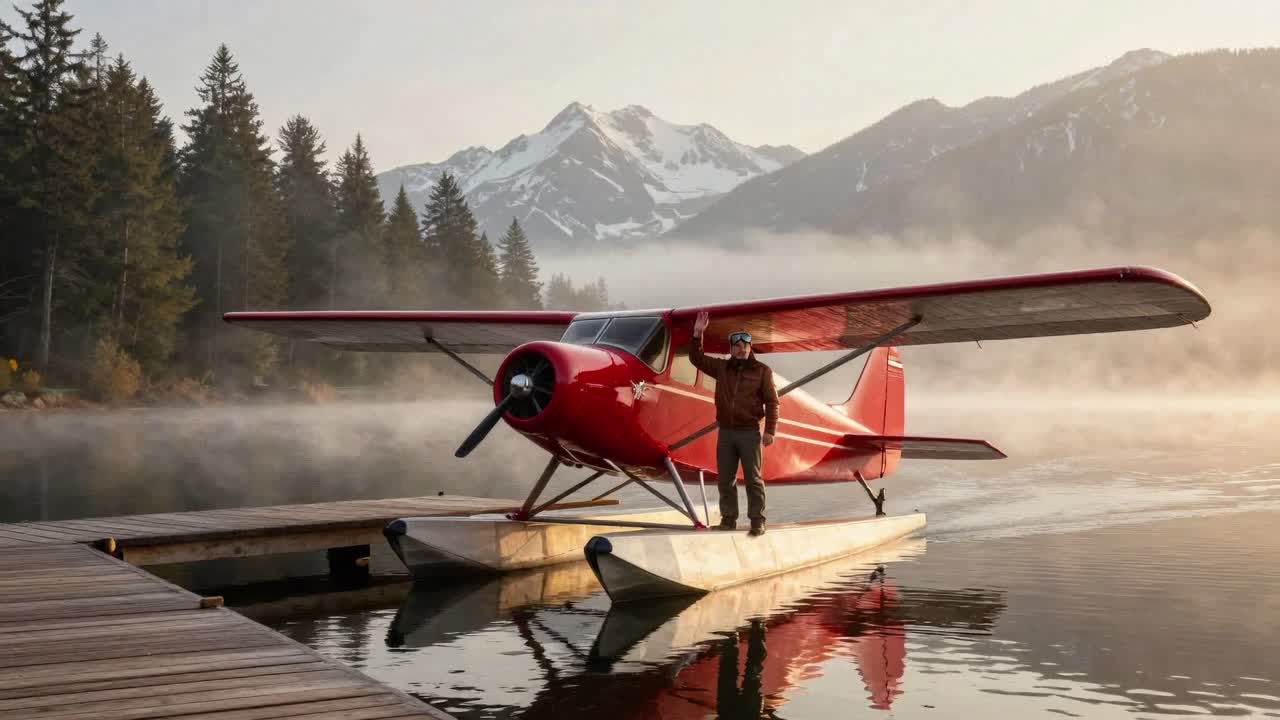
水上飞机待发,一次生成画面和声音

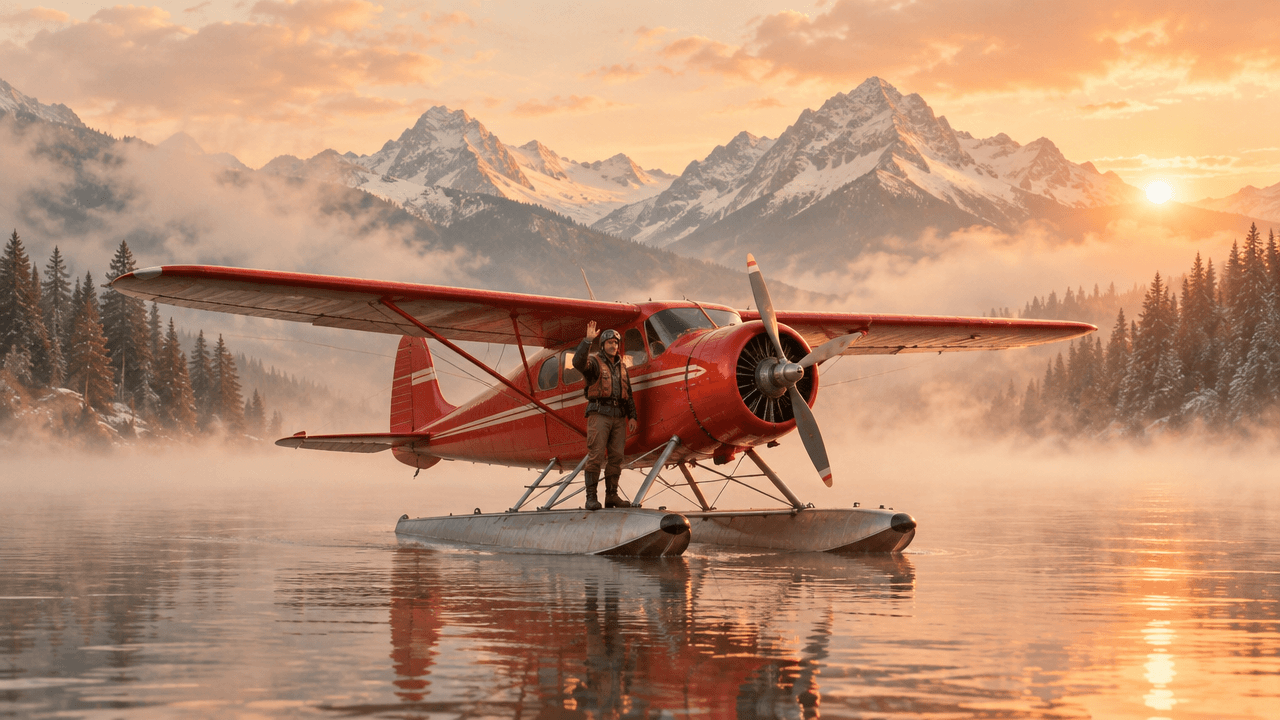
首帧是一张 1280×720 的静帧:晨雾中的湖面、停在岸边的小型水上飞机。提示词只写要加入的动作——飞行员挥手、螺旋桨转起来、水面泛起涟漪、镜头缓慢推进——没有重复画面里已有的内容。原生音频默认开启,成片带一条与画面同步的音轨。

提示词(英文)

The pilot waves, the seaplane engine starts and the propeller spins up, gentle ripples spread across the misty lake as the camera slowly pushes in, golden morning light
首帧1280×720
生成视频3s · 540p · 16:9
竖屏 · 原生音频5s720p4:7

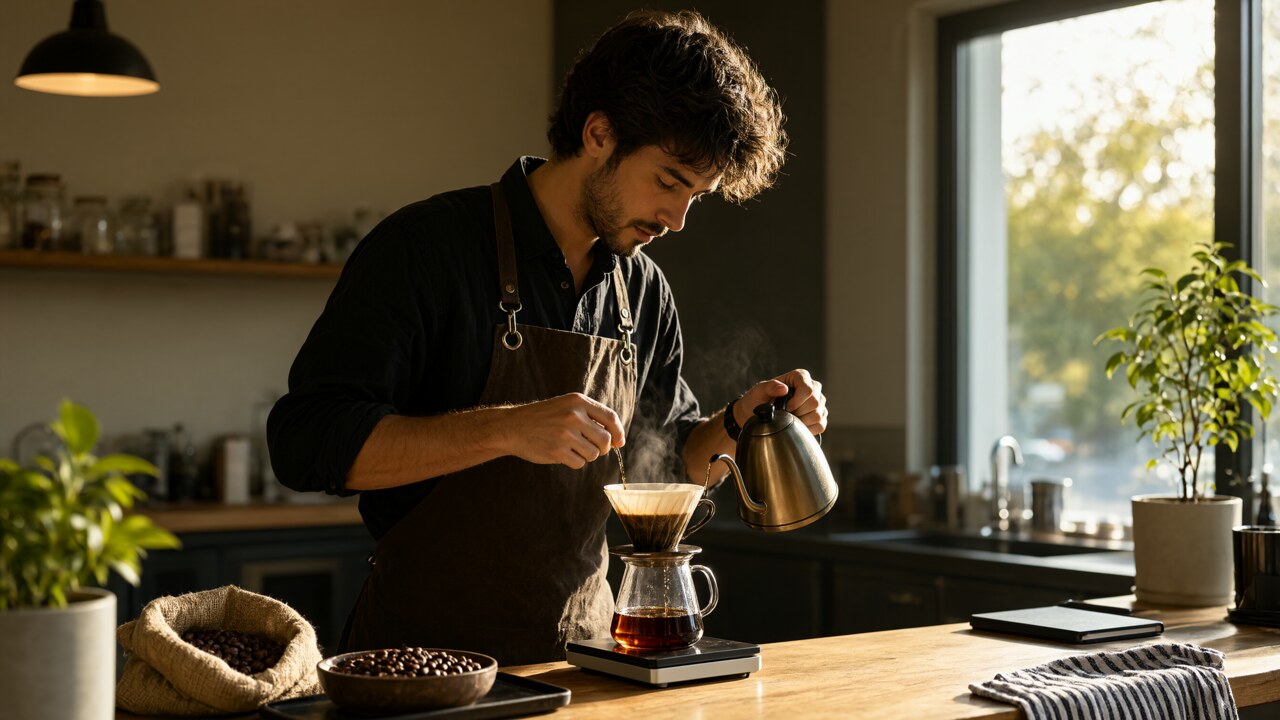
竖版咖啡师拉花,画幅跟随首帧

首帧是一张竖版照片(732×1280,比例 4:7)。没有设置任何画幅参数,成片就是 724×1268 的竖屏——这是图生视频画幅跟随首帧的直接演示。提示词让咖啡师放下奶缸、拉花定型、抬头看镜头微笑,音频保持开启,成片带一条与画面同步的音轨。适合抖音 / Reels / Shorts 这类竖屏位。

提示词(英文)

The barista sets the milk pitcher down on the counter, the latte art in the cup settles into a leaf pattern and steam rises from it; she lifts her eyes to the camera and smiles. Cafe murmur and the hiss of the espresso machine. Slow handheld push-in, warm morning light through the window.

首帧732×1280
生成视频5s · 720p · 4:7
540p · 无声素材3s540p7:4

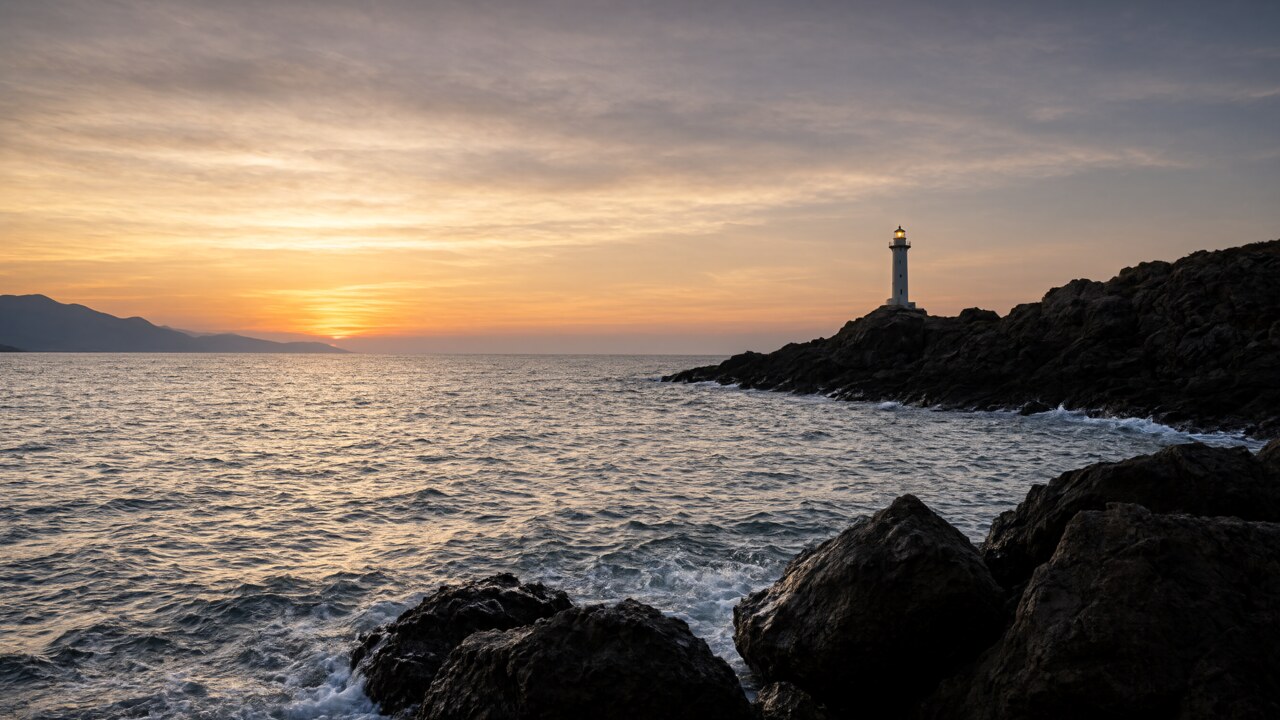
黄昏灯塔,关掉音频做循环背景

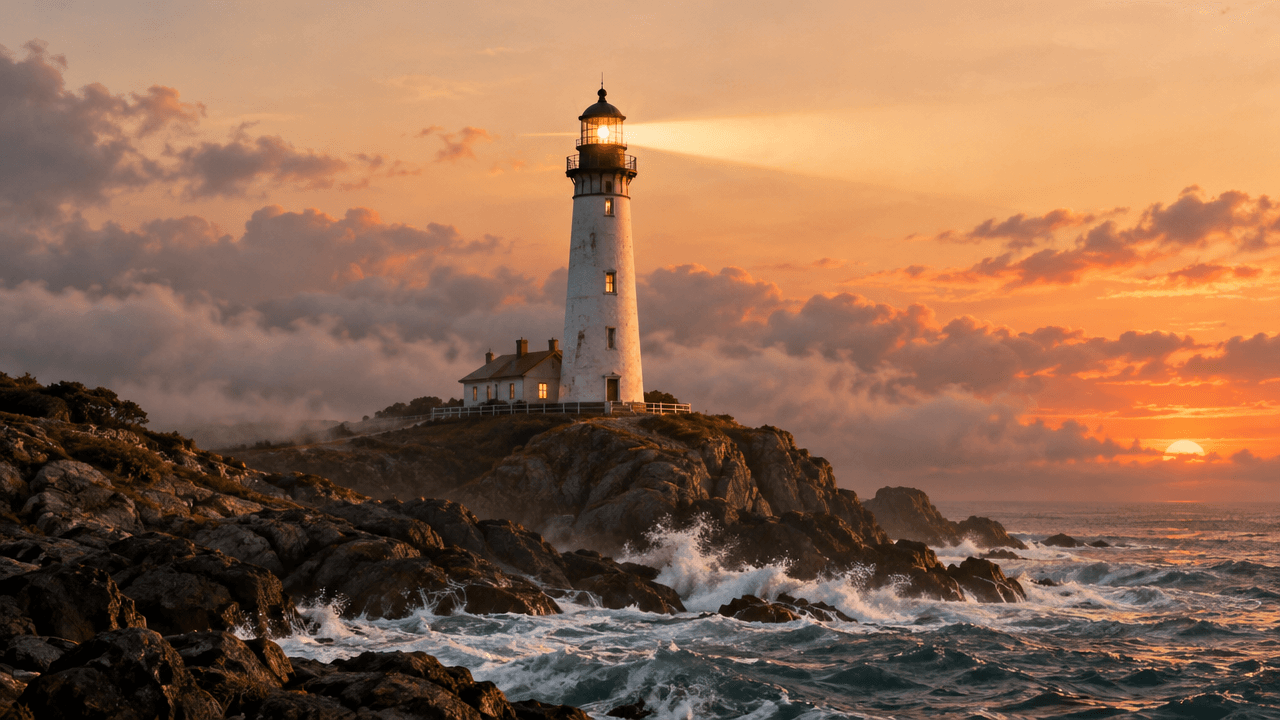
同样是首帧驱动的 3 秒短片,这次把 audio 关掉、分辨率压到最低的 540p:海浪拍碎在礁石上、灯塔灯亮起、低云掠过塔身、镜头缓慢推近。首帧是 1280×732(7:4),成片就输出 952×544 的 7:4 画面,再次说明没有比例参数可调。没有音轨的成片体积小、可以直接当网页头图或信息流的循环背景,需要声音时再在后期配乐;这也是先用最低档试提示词和运镜的做法。

提示词(英文)

Waves break white against the rocks below, spray flying up; the lighthouse lamp switches on and brightens across the beam, low clouds drift slowly past the tower, and the camera pushes in slowly toward the lighthouse. Silent footage intended as a looping background.

首帧1280×732
生成视频3s · 540p · 7:4

如何选择相关视频模型

按手里已有的素材选:只有一张图、且它必须成为成片第一帧时用图生视频;有多张参考图或要锁定角色音色用参考生视频;需要首尾帧控制或更长时长看 Seedance 2.5;想要固定 5 秒快速出片看 Ray 3.2。

模型规格

输入
首帧图片 + 可选提示词
时长
3-16 秒(整数秒,默认 5 秒,按提交时长计费)
分辨率
540p / 720p / 1080p / 2K / 4K,默认 720p
画幅
完全跟随首帧图片,1:4-4:1
图片要求
JPG / JPEG / PNG / WebP,单张 ≤50MB
音频
原生音频默认开启;关掉输出无声成片,不影响价格
提示词长度
可选,≤20,000 字符,英文最稳定
模型 ID
vidu-q4-preview/image-to-video

当前价格:查看实时定价

如何使用 Vidu Q4 Preview Image-to-Video

首帧
1 张,1:4–4:1
01

准备首帧图片

选一张构图完整、主体清晰的图片:它决定成片的主体、景别、光线和画幅。宽高比保持在 1:4 到 4:1 之间,做竖屏就上传竖版。

主体运动
镜头路径
音频开关
02

写动作、镜头和声音

只写要新增的内容:谁做什么、镜头怎么走、说什么话或有什么环境声;选 3-16 秒和分辨率档位,需要无声成片就关掉 audio。

Playground
POST /v1/tasks
03

先试低档,再出交付版本

在 Playground 用低档短视频确认动作和构图,复制下方请求接入 API;同一提示词换高档、拉长时长重跑,就是交付版本。

提示词写法

  1. 01

    只写变化,不重复画面

    首帧已经决定了主体、服装和背景,提示词只补动作、镜头和声音。

    示例:the pilot waves, the propeller spins up, ripples cross the lake

  2. 02

    一次只写一个镜头运动

    推镜、跟拍、环绕、手持或固定机位,写一个明确的动作比叠加多个更稳。

    示例:slow push-in toward the lighthouse, fixed on the tower

  3. 03

    开启音频时把声音写出来

    点明对白、环境声和音效,生成的音轨会更贴合动作;具体声音比“电影感”有效。

    示例:engine coughs, water laps at the shore, gulls overhead

  4. 04

    按动作量选时长

    3-5 秒写一个动作加一次运镜;更长的片段按先后顺序写两三个节拍。

    示例:the bear walks up to the cabin, speaks, then waves at the camera

API 快速示例

curl --request POST 'https://api.hiapi.ai/v1/tasks' \
  --header 'Authorization: Bearer YOUR_API_KEY' \
  --header 'Content-Type: application/json' \
  --data '{
  "model": "vidu-q4-preview/image-to-video",
  "input": {
    "image_url": "https://static.hiapi.ai/admin-assets/2026/10/18/1792306166627-5fe5873f6127873d-seaplane-takeoff-input.jpg",
    "prompt": "The pilot waves, the seaplane engine starts and the propeller spins up, gentle ripples spread across the misty lake as the camera slowly pushes in, golden morning light",
    "duration": 3,
    "resolution": "540p",
    "audio": true
  }
}'
创建请求会返回 taskId;结果需要异步获取。查看完整 API 文档

关于 Vidu Q4 Preview Image-to-Video

图片决定画面,提示词补上动作和声音

Vidu Q4 Preview 图生视频把首帧图片当作成片的第一帧:主体、构图、景别、光线和色调都由图片决定,成片从这张图开始。提示词只写要新增的部分——谁做什么动作、镜头怎么移动、出现什么声音或说哪句话——模型在生成画面的同时生成与动作对齐的对白、环境声和音效。已经有商品主图、海报、摄影作品或角色立绘的团队,可以直接把它们变成 3-16 秒的有声片段,不需要单独的配音和口型对齐步骤。

画幅完全跟随图片:横图出横屏、竖图出竖屏,不需要设置比例,首帧宽高比保持在 1:4 到 4:1 之间即可。分辨率分 540p、720p、1080p、2K、4K 五档,时长按整数秒从 3 到 16 选择,两者组合决定每秒价格。先用 540p 或 720p 的短片段确认动作和镜头,定稿再换高档、拉长时长,花费更少。

原生音频默认开启;做循环背景、后期自己配乐或需要压字幕时关掉 audio,得到干净的无声素材,价格不变。同一个模型 ID 同时覆盖草稿和交付:短、低档的版本用来试提示词,长、高档的版本用来发布。

Vidu Q4 Preview Image-to-Video 封面
提供商
Vidu
任务
图生视频(首帧驱动)
输入
首帧图片 + 可选提示词

图生视频能做什么

让一张静帧带声音动起来

首帧锁定主体和光线,提示词写清动作、镜头和声音,画面与对白、环境声、音效一次生成。适合口播开场、产品介绍、氛围空镜和需要现场感的社媒短片;不想要生成的声音时关掉 audio 重跑,价格不变。

查看对应案例

保住原图的画幅和构图

成片画幅跟随首帧,横图出横屏、竖图出竖屏,没有比例参数。竖屏内容直接上传竖版首帧即可;本页案例首帧是 732×1280 的 4:7,成片是 724×1268,同样是 4:7,适合抖音、Reels、Shorts 和竖屏信息流。

查看对应案例

按发布位置选分辨率档位

五档分辨率对应五种发布位置:540p 试提示词、运镜和小尺寸循环背景,720p 覆盖多数社媒与网页,1080p 用于常规投放,2K 适合大屏和电视,4K 留给展陈、影院级画面或需要后期裁切的镜头。同一段提示词换档重跑即可,写法不用改。

查看对应案例

把提示词写成动作清单

3-16 秒适合一到两个动作加一次镜头运动。按先后顺序写,比堆砌形容词更可控;提示词只描述新增内容,画面里已有的主体、服装和背景不用重复。英文提示词最稳定,中文同样可用,上限 20,000 字符。

适合的应用场景

商品与品牌开场

商品与品牌开场

商品主图或品牌静帧加一段提示词,做成带声音的 3-5 秒开场,主体、材质和配色保持原样。

竖屏社媒短片

竖屏社媒短片

竖版首帧直接出竖屏成片,不裁切;草稿用低档,确认后按投放位重跑。

循环背景与无声空镜

循环背景与无声空镜

关掉 audio 得到干净的无声素材,用于网页头图、菜单屏和展位循环。

4K 交付与细节镜头

4K 交付与细节镜头

展陈、影院级画面或后期要裁切的镜头,先用低档试,再用 4K 出交付版本。

在 HiAPI 上使用 Vidu Q4 Preview

同一个 API Key 即可调用图生视频和参考生视频两个端点,任务记录集中保存成片、参数和消费明细,方便对比不同提示词、画幅和分辨率档位,也方便按秒核对费用。

查看全部文章
需要比较不同模型和计费档位?查看全部模型实时价格

常见问题

图生视频可以自己设置画幅吗?

不能。成片画幅完全跟随首帧图片:传横图出横屏、传竖图出竖屏,所以想要 9:16 竖屏就准备一张竖版首帧。首帧宽高比需在 1:4 到 4:1 之间,过于狭长的图片会在提交时被拒绝。

audio 开关有什么用?

原生音频默认开启,会生成与画面同步的对白、环境声和音效;关闭后输出纯画面无声视频,适合做循环背景、后期自己配乐或加字幕。开关不影响价格。

时长和价格是什么关系?

按提交的整数秒时长乘以所选分辨率的每秒单价计费,音频开关和图片数量都不参与计价。分辨率越高每秒单价越高,4K 档约为 540p 档的 8.7 倍,具体金额以定价页为准。

五档分辨率分别适合什么场景?

540p 用来试提示词和镜头,也够做小尺寸循环背景;720p 覆盖大多数社媒与网页;1080p 用于常规投放;2K 适合大屏和电视展示;4K 用于展陈、影院级画面或需要后期裁切二次构图的镜头。定稿前先用低档试,定稿再用高档出。

和 Vidu Q3 Mix 有什么区别?

Vidu Q3 Mix 用 1-7 张参考图重新组织画面,720P/1080P 两档、1-16 秒,参考图不作为成片第一帧。Vidu Q4 Preview 图生视频把图片当作成片第一帧,时长 3-16 秒,分辨率最高到 4K,并默认生成原生音频。首帧必须等于手里这张图时选 Q4 Preview。

和参考生视频(reference-to-video)有什么区别?

图生视频把图片当作成片的第一帧,出来的画面从这张图开始;参考生视频把图片当作人物、道具或场景的样子,重新生成全新构图,参考图不会原样出现在开头。想要“这张图动起来”用图生视频。

首帧图片有什么要求?

支持 JPG / JPEG / PNG / WebP,单张不超过 50MB,宽高比在 1:4 到 4:1 之间。建议首帧的构图和光线就是最终效果的样子,因为它决定了成片的主体、景别和色调。

提示词该怎么写?

只写要新增的内容:谁做什么动作、镜头怎么走、有什么声音或说哪句话。不要重复描述画面里已经有的东西。英文提示词最稳定,中文同样可用;长度上限 20,000 字符。

提示词是必填的吗?

不是。不传提示词时,模型会根据首帧内容自行推断动作和镜头;传了提示词就能控制动作顺序、镜头路径和声音。两种方式都按提交的时长和分辨率计费。

不传的参数默认是什么?

时长默认 5 秒,分辨率默认 720p,audio 默认开启。三项都可以按任务覆盖;计费按提交的整数秒时长和所选分辨率档位计算。