TL;DR
- GPT-6.1 Terra(
gpt-6.1-terra)是 OpenAI 2026 年 10 月 26 日发布的中端模型,能读图、能调工具、能按 JSON schema 严格输出。已在 HiAPI 上线,打开模型页在线试,注册即领最高 2,000 积分($1)。 - 价格:每百万 token 输入 $0.25、输出 $1.25。一次短回复(约 90 输入、80 输出 token)约 $0.0001。
- 最快的调法:
POST https://api.hiapi.ai/v1/responses,input传数组,stream: true,store: false。
GPT-6.1 Terra 能做什么
- 6 个推理档位:none、low、medium(默认)、high、xhigh、max。批量任务可以直接关掉推理(none)。
- 读图:文字和图片放进同一条消息,输出文字。
- 严格 JSON:给一个 JSON schema,返回的字段和类型完全按 schema 来。
- 工具调用:模型决定调哪个函数、传什么参数,你执行后把结果交回,它再写最终回答。
上下文 1.05M token(单次输入最多 922K),最大输出 128K,知识截止 2026 年 6 月。
下面这张商品图,配上一个上架信息的 schema,Terra 用 10 秒返回了这样的 JSON:
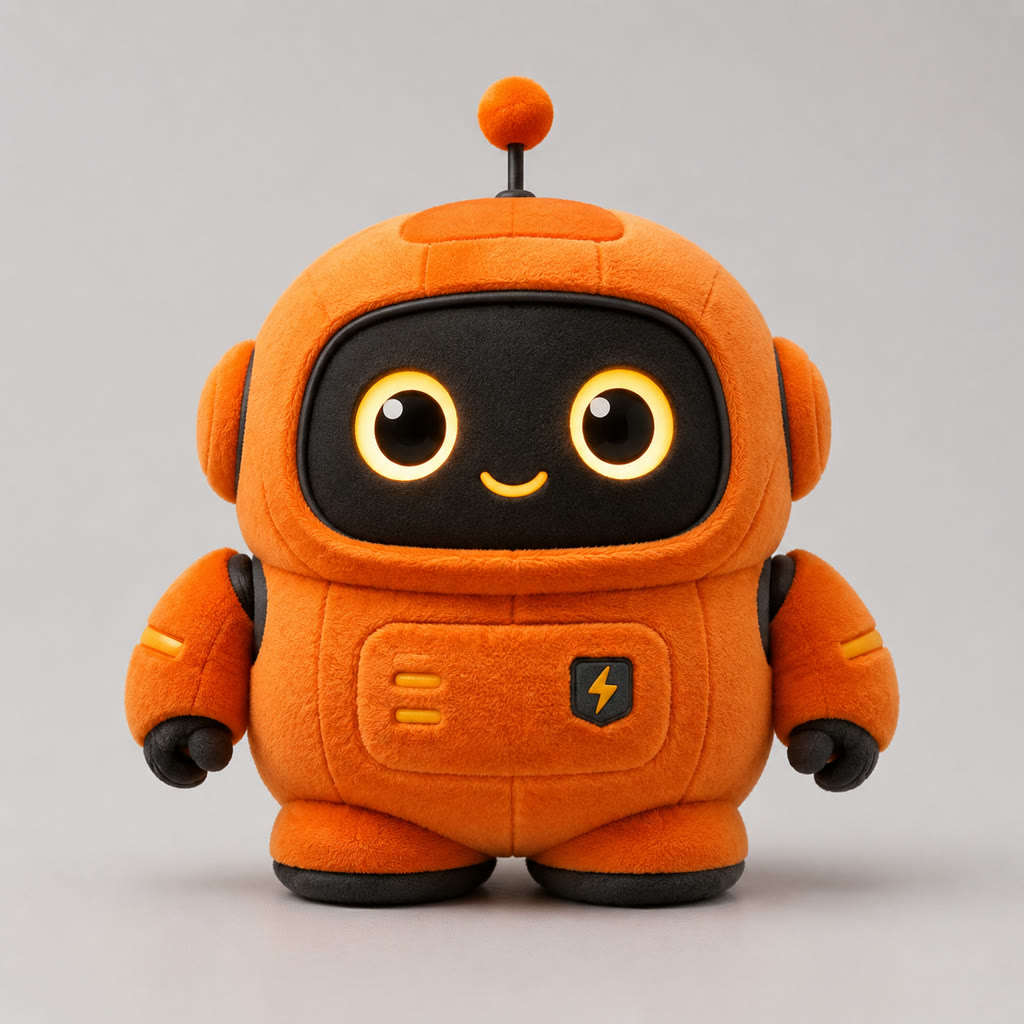
{"product_name":"橙色机器人毛绒玩偶","category":"毛绒玩具","material":null,"main_color":"橙色","selling_points":["机器人造型设计,外观可爱","橙色主体搭配黑色细节,配色醒目","圆润立体造型,适合作为摆件或陪伴玩偶"],"target_buyer":null}
gpt-6.1-terra,medium,438 输入 / 163 输出 token,$0.0003。提示词要求「看不出来的字段填 null」,所以材质和适合人群都返回了 null。
两个接口怎么选
| Responses(默认) | Chat Completions | |
|---|---|---|
| 地址 | POST /v1/responses | POST /v1/chat/completions |
| 流式 | 必须 stream: true | 流式、非流式都可以 |
| 推理档位字段 | reasoning.effort | reasoning_effort |
| 严格 JSON 字段 | text.format | response_format |
| 适合 | 新项目、要读图和工具调用 | 已有 OpenAI Chat 代码直接换 base URL |
两个接口都用 https://api.hiapi.ai 和同一个 HiAPI key。
两条上手路线
浏览器(不写代码)
- 打开 GPT-6.1 Terra 模型页,登录。
- 在 Playground 里选推理档位,输入问题或粘贴图片。
- 回答以流式显示,跑完会显示 token 用量、耗时和估算费用。
API
- 在控制台的 API Keys 页面创建 key,存进环境变量
HIAPI_API_KEY。 - 复制下面的 curl 跑通第一次调用。
- 换成 Python,按事件类型读取流式结果。
curl:第一次调用
curl -N https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "input": [
      {"type": "message", "role": "user",
       "content": [{"type": "input_text", "text": "用三句话解释什么是幂等性。"}]}
    ],
    "stream": true,
    "store": false,
    "reasoning": {"effort": "low"}
  }'
返回的是 SSE 流,事件依次是:
response.created → response.in_progress → response.output_item.added
→ response.content_part.added → response.output_text.delta(很多次)
→ response.output_text.done → response.content_part.done
→ response.output_item.done → response.completed
正文在 response.output_text.delta 的 delta 里,token 用量在最后 response.completed 的 response.usage 里。流里可能还会出现别的事件类型,按 type 分发,不认识的跳过即可。
Python:流式读取
import json, os, requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

body = {
    "model": "gpt-6.1-terra",
    "input": [{"type": "message", "role": "user",
               "content": [{"type": "input_text", "text": "用三句话解释什么是幂等性。"}]}],
    "stream": True,
    "store": False,
    "reasoning": {"effort": "low"},
}

usage = None
with requests.post(API, headers=HEADERS, json=body, stream=True, timeout=600) as r:
    r.raise_for_status()
    for line in r.iter_lines():  # 按字节读,自己用 UTF-8 解码
        if not line.startswith(b"data:"):
            continue
        event = json.loads(line[5:].decode("utf-8"))
        kind = event.get("type")
        if kind == "response.output_text.delta":
            print(event["delta"], end="", flush=True)
        elif kind == "response.completed":
            usage = event["response"]["usage"]
        elif kind in ("response.failed", "response.incomplete"):
            raise RuntimeError(event["response"].get("error") or event["response"].get("incomplete_details"))

print("\n", usage)
两个容易踩的坑:
- 不要用
iter_lines(decode_unicode=True)。response.completed这一行常常超过 8KB,requests 在不知道编码时会按 latin-1 解码,中文会变成乱码。按字节读,再用 UTF-8 解码。 - 失败也走 HTTP 200。生成失败时,流里来的是
response.failed,usage 为空、不扣费。要单独判断,然后重试。
Chat Completions:已有代码直接换
curl https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [{"role": "user", "content": "用三句话解释什么是幂等性。"}],
    "reasoning_effort": "low"
  }'
用 OpenAI 官方 Python SDK,只改 base_url 和 key:
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=os.environ["HIAPI_API_KEY"])
resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[{"role": "user", "content": "用三句话解释什么是幂等性。"}],
    reasoning_effort="low",
)
print(resp.choices[0].message.content)
非流式直接返回完整的 choices[0].message.content。加 "stream": true 就是标准的 chunk 流,以 data: [DONE] 结束。同一条客服回复提示词,非流式 33 秒拿到完整回答;流式 2.5 秒出第一个字,4.5 秒结束。面向用户的场景用流式。
推理档位
Responses 写 "reasoning": {"effort": "none"},Chat 写 "reasoning_effort": "none"。默认 medium。同一条需求拆解提示词,medium 一次 $0.002–0.004,max 一次 $0.012–0.014。各档的 token 和耗时见 GPT-6.1 Terra API 价格。
读图
在同一条消息的 content 里加一项 input_image,图片用公开的 HTTPS 地址:
{"type": "message", "role": "user", "content": [
  {"type": "input_text", "text": "描述图片主体和两个可见细节。"},
  {"type": "input_image", "image_url": "https://static.hiapi.ai/example/subject-1.jpg", "detail": "low"}
]}
严格 JSON
在请求体里加 text.format(Chat 用 response_format):
"text": {"format": {
  "type": "json_schema", "name": "listing", "strict": true,
  "schema": {
    "type": "object", "additionalProperties": false,
    "required": ["product_name", "main_color", "material"],
    "properties": {
      "product_name": {"type": "string"},
      "main_color": {"type": "string"},
      "material": {"type": ["string", "null"]}
    }
  }
}}
strict 模式下,每个属性都要写进 required,可以为空的字段用 ["string", "null"]。返回的正文就是一段可以直接 json.loads 的 JSON。
工具调用:两轮
第一轮在请求里带上 tools:
"tools": [{"type": "function", "name": "get_order_status",
  "description": "Look up shipping status by order ID",
  "parameters": {"type": "object", "additionalProperties": false,
    "required": ["order_id"], "properties": {"order_id": {"type": "string"}}},
  "strict": true}]
问「订单 HX-20481 到哪了?」,模型不写正文,只返回一个 function_call:name 是 get_order_status,arguments 是 {"order_id":"HX-20481"},另带一个 call_id。
第二轮,input 里依次放:原来的用户消息、上一轮返回的那条 function_call,再加上你执行函数的结果:
{"type": "function_call_output", "call_id": "call_…", "output": "{\"status\":\"in_transit\",\"carrier\":\"SF Express\",\"eta\":\"2026-10-30\"}"}
模型据此回答:「订单 HX-20481 正在运输中,由顺丰速运承运……预计送达:2026 年 10 月 30 日」。两轮一共约 $0.00016。回传时用 call_id,不是 fc_ 开头的 id。
命中缓存
body 里传 prompt_cache_key,请求头里传值相同的 session_id,提示词开头那段保持逐字不变:
-H "session_id: shop-faq-v1" \
-d '{"model": "gpt-6.1-terra", "prompt_cache_key": "shop-faq-v1", ...}'
我们用约 3,290 token 的客服手册做开头,连续问了 4 个问题,第 4 次命中 3,072 个缓存 token,这次花费从约 $0.001 降到 $0.00013。命中多少看 usage 里的 input_tokens_details.cached_tokens。
参数表(Responses)
| 字段 | 必填 | 取值 | 说明 |
|---|---|---|---|
model | 是 | gpt-6.1-terra | |
input | 是 | 数组 | 消息项,传字符串会返回 400 |
stream | 是 | true | 传 false 返回 400 |
store | 否 | false | 对话历史由客户端保存,每轮重放 |
reasoning.effort | 否 | none / low / medium / high / xhigh / max | 默认 medium |
text.format | 否 | json_schema | 严格 JSON |
tools、tool_choice | 否 | 函数定义 | 工具调用 |
prompt_cache_key | 否 | 字符串 | 配合请求头 session_id 命中缓存 |
instructions | 否 | 字符串 | 回答要求 |
temperature、top_p 不可调,回答长度上限也不能设,需要控制长度就写在提示词里。
你会遇到的报错
| 原因 | 状态码 | 返回 |
|---|---|---|
档位写错(如 "turbo") | 400 | reasoning.effort: is outside allowed values |
stream 传了 false | 400 | stream: must be true |
没传 input | 400 | input: is required |
| 多了不认识的字段 | 400 | request.zz: unregistered public parameter |
| 模型名写错 | 400 | model_not_found,附 request ID |
| 生成失败 | 200 | 流里是 response.failed,error.code 为 generation_service_unstable,不扣费,重试即可 |
参数错误在提交时就会返回 400,不会生成,也不扣钱。
上线前注意
- 超时设长一点:推理档位高、回答长的请求,我们遇到过 4 分钟以上才结束的。客户端超时至少设 10 分钟。
- 失败要重试:
response.failed和网络中断都按「等几秒再重试」处理,最多重试 2–3 次。 - 控制输入在 272K 以内:超过后整次请求按长上下文价,花费接近翻倍。
- 长前缀用缓存:系统提示、知识库这类固定开头,配好
prompt_cache_key和session_id。
常见问题
能用 OpenAI 官方 SDK 吗?
可以。Chat Completions 的请求和返回格式与 OpenAI 一致,把 base URL 改成 https://api.hiapi.ai/v1、key 换成 HiAPI key 即可。
多轮对话怎么做?
store 必须是 false,服务端不保存对话。每轮把需要的历史消息一起放进 input 重新发送,重放的部分按输入计费,配合缓存可以省下大半。
支持哪些输入?
文字和图片,输出是文字。模型页 Playground 一次最多传 4 张图,每张不超过 10 MB。
和 GPT-6.1 Sol 怎么选?
Terra 价格是 Sol 的一半,多一个 none 档;我们的测试里 Sol 回得更快。同题对照见 GPT-6.1 Terra vs GPT-6.1 Sol。
现成的场景提示词见 GPT-6.1 Terra 提示词大全。复制上面的 curl,把问题换成你自己的,跑通第一次调用;不想写代码就打开模型页直接试。