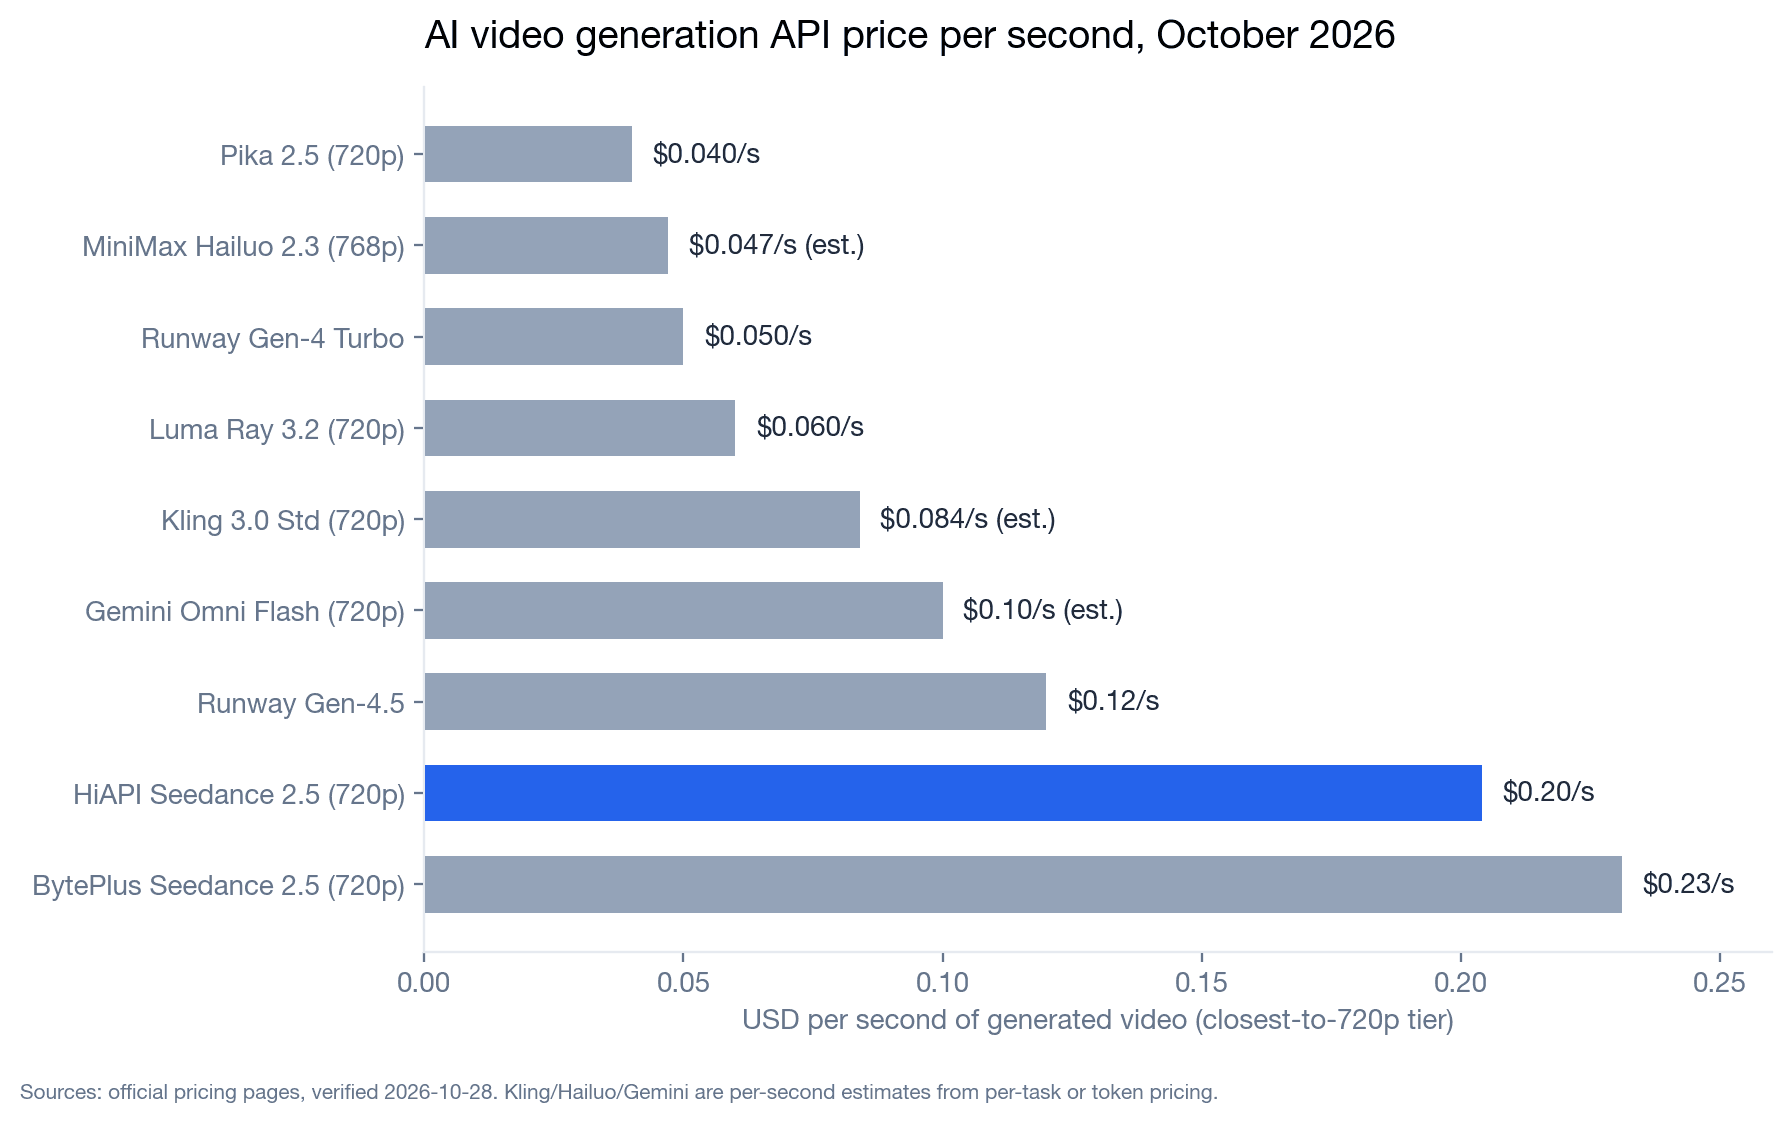如果你的图像或视频生成已经跑在 Replicate 上,正在看替代方案,你最关心的大概是这几件事:哪些调用要改,webhook 处理逻辑会受什么影响,计费单位怎么对应,迁移时哪里容易出错。本文逐一回答。Replicate 一侧的信息来自它公开的文档和定价页,hiapi 一侧来自实时模型清单、/api/pricing 定价接口和官方文档,均在 2026 年 11 月核对。写作过程中我们也在 hiapi 上发了真实请求,文中的响应都来自这些请求。
先说清楚:Replicate 是很强的平台。如果你依赖大量社区模型、自定义微调,或者要部署自己的模型,它能做的事 hiapi 并不打算覆盖。hiapi 适合的是另一类团队:主要调用知名商用图像和视频模型,希望所有模型共用一套异步调用约定。
平台总览
| 维度 | Replicate | hiapi |
|---|---|---|
| 能跑什么 | 官方模型、大量社区模型,以及你自己的模型和微调 | 精选的商用图像、视频、音频模型(撰写时异步任务接口上有 98 个模型) |
| 创建任务 | 官方模型用 POST /v1/models/{owner}/{name}/predictions,或 POST /v1/predictions 带 version | 所有图像、视频、音频模型统一 POST /v1/tasks,传 model + input |
| 鉴权 | Authorization: Bearer <token> | Authorization: Bearer <key> |
| 同步等待 | Prefer: wait=n 最多保持请求 60 秒 | 无,一律异步(轮询或回调) |
| 状态值 | starting、processing、succeeded、failed、canceled、aborted | queued、handling、archiving、success、fail |
| Webhook 事件 | start、output、logs、completed(可过滤) | 只在终态回调(when: "final"),success 和 fail 都会触发 |
| Webhook 签名 | 对 id.timestamp.body 做 HMAC-SHA256,webhook-* 请求头,whsec_ 密钥 | 对 timestamp.body 做 HMAC-SHA256,X-HiAPI-* 请求头,密钥在控制台设置 |
| 提交幂等 | 我们查阅的文档中没有涉及 | Idempotency-Key 请求头,重放返回原 taskId |
| 输出保留(API) | 默认 1 小时后删除输入、输出、文件和日志 | temp 存储默认约 7 天;可选 persistent 存储(按大小计费) |
| 计费单位 | 部分模型按输出计费,多数模型按硬件运行秒数计费 | 按输出计费:图像按张,视频按秒,音频按首或按次 |
表中每一格都来自双方各自的文档或我们的实测请求。双方无法同时核实的维度,我们没有放进来。
关键差异
模型覆盖:广度 vs 精选清单
Replicate 的长处是广度。除了官方模型,你还可以跑社区模型、锁定某个 version 哈希,或上传自己的模型。很多商用模型系列两边都有:Replicate 上有 FLUX、Nano Banana、Seedance、Kling、Veo、Wan、Seedream 的模型页,hiapi 也提供这些系列的当前版本。如果你的产品依赖某个特定社区 checkpoint 或私有微调,那部分业务 hiapi 替代不了。
hiapi 的清单更窄,集中在生产可用的商用模型上,包括 Seedance 2.5、Kling 3.0、Veo 3.1、Nano Banana Pro、GPT Image 2 等当前版本。完整清单和每个模型的输入参数在 hiapi 模型页。
异步约定:你的代码实际要改哪里
两个平台都以异步为主,差别体现在轮询循环和 webhook 处理上:
- hiapi 没有同步捷径。 如果你靠 Replicate 的
Prefer: wait一次请求拿回图片,换到 hiapi 需要“提交后轮询”或者用回调。我们这次用 FLUX.1 [schnell] 文生图实测,任务从archiving进入success,任务的created和completed时间戳相差 6 秒,每 3 秒轮询一次,第 4 次拿到结果。中文提示词直接传入即可,不需要额外处理。 - 只有终态回调。 Replicate 可以推送
start、流式output和logs事件。hiapi 只在任务进入success或fail时回调一次,回调 body 与GET /v1/tasks/:id返回的data对象一致。如果你的界面靠logswebhook 展示实时进度,在 hiapi 上要改用轮询。 - 至少一次投递。 回调投递失败时,hiapi 会立即重试,之后在 +1 分钟、+5 分钟、+20 分钟再试。同一个
taskId可能到达不止一次,按它去重。 - 状态名会变。
succeeded/failed对应success/fail,canceled/aborted没有对应状态。hiapi 的任务失败时,详情接口仍返回 HTTP 200,所以要判断data.status,不要只看 HTTP 状态码。
计费单位与价格
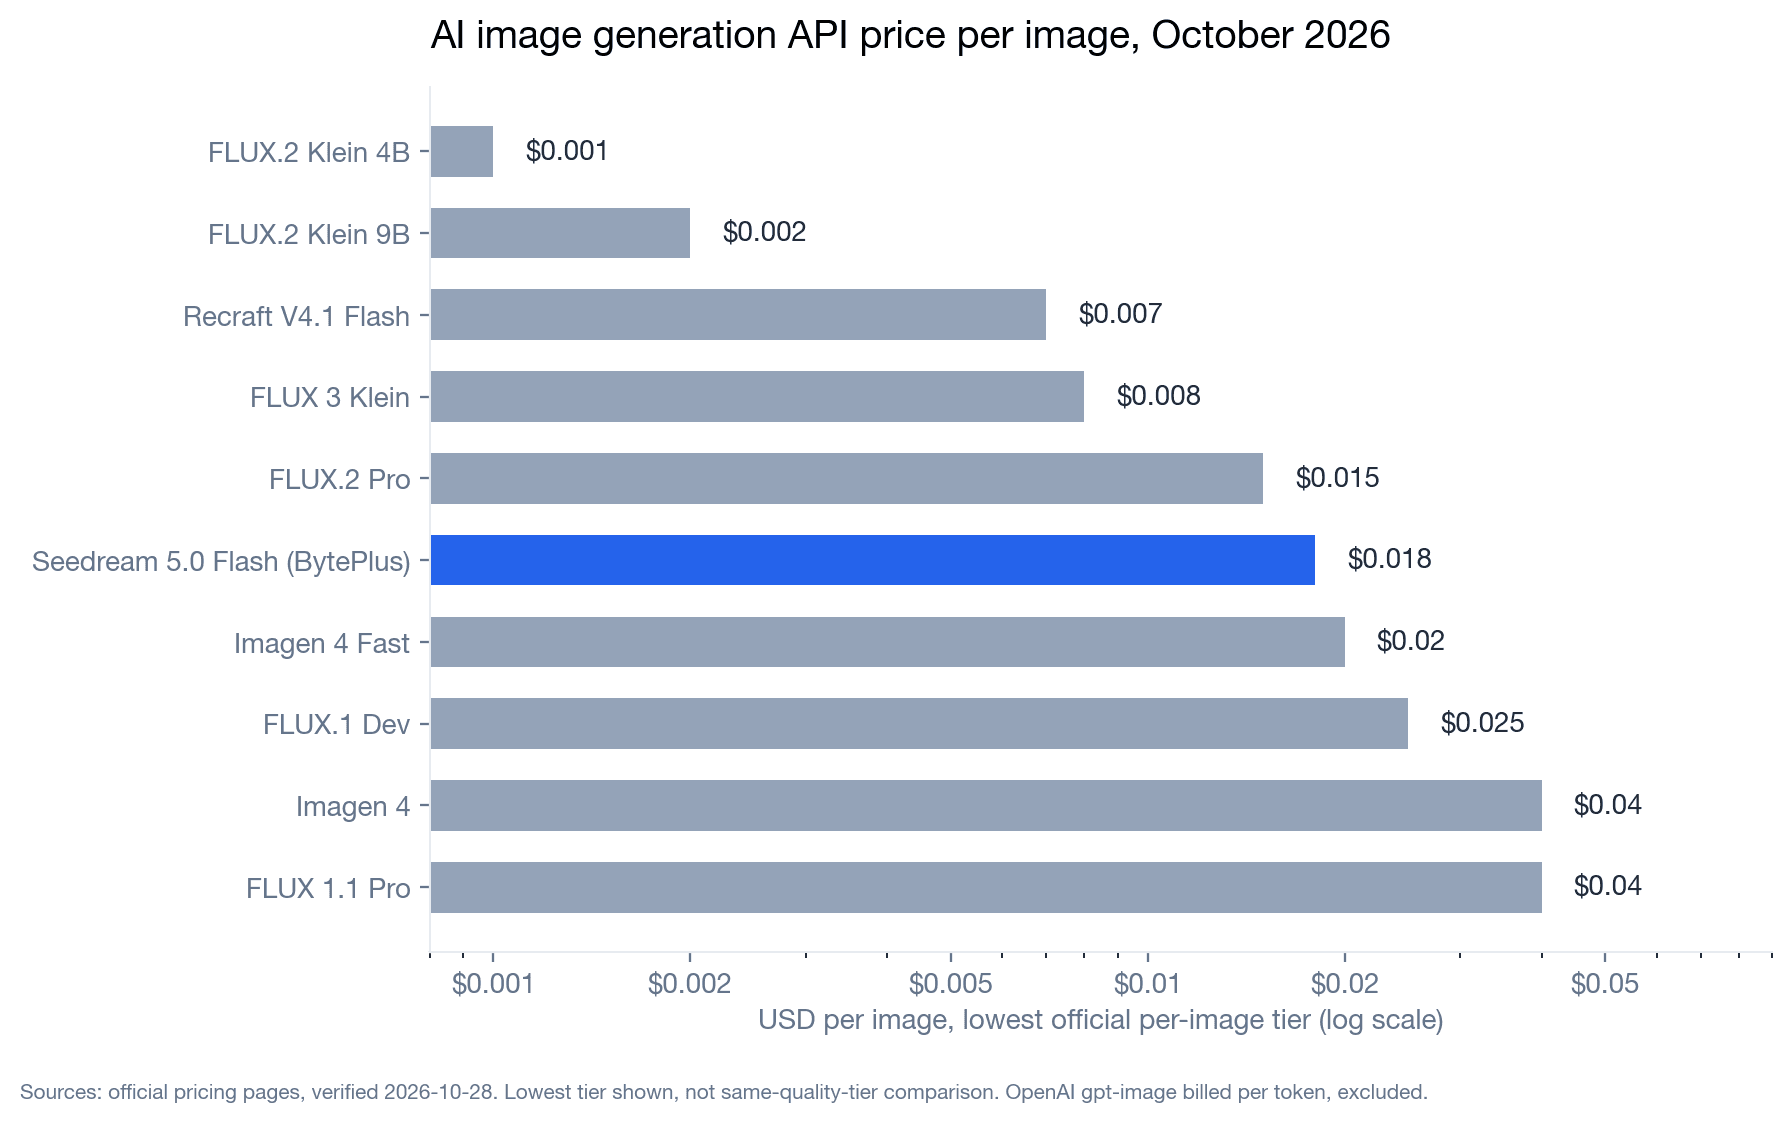
Replicate 对多数公开模型按硬件时间计费(按秒,单价取决于 GPU),部分模型按输入和输出计费。它的定价页上,FLUX1.1 [pro] 是每张 $0.04,FLUX.1 [schnell] 是每千张 $3.00。预测开始后再取消,已运行的时间照样计费;还没开始就被中止(aborted)的预测不收费。
hiapi 所有任务模型都按输出计费,费用和模型跑在哪种 GPU 上无关。下表来自 hiapi 实时 /api/pricing 接口,2026 年 11 月核对:
| hiapi 上的模型 | model id | 基础标价 |
|---|---|---|
| FLUX.1 [schnell] | flux-schnell/text-to-image | $0.005 / 张 |
| FLUX1.1 [pro] | flux-1.1-pro | $0.05 / 张 |
| FLUX.2 [pro] | flux-2/text-to-image | $0.05 / 张 |
| Nano Banana Pro | nano-banana-pro | $0.0285 / 张 |
| GPT Image 2 | gpt-image-2/text-to-image | $0.03 / 张 |
| Kling 3.0 文生视频 | kling-3.0/text-to-video | $0.129 / 秒 |
| Seedance 2.5 文生视频 | seedance-2.5/text-to-video | $0.204 / 秒 |
| Veo 3.1 Fast 文生视频 | veo-3.1-fast/text-to-video | $0.25 / 秒 |
部分模型按分辨率或时长分档,高档位高于基础价。最新数字以 定价页 为准。
在两边都公布了单张价格的两个 FLUX 模型上,Replicate 更便宜:FLUX1.1 [pro] 是 $0.04 对 $0.05,schnell 是 $0.003 对 $0.005。这一点我们如实承认。其他模型的价差取决于你比的是哪个版本、哪个分辨率,建议拿你调用量最大的三个模型逐个比价再做决定。另外,hiapi 上失败的任务不扣费:创建时预扣的金额,在任务以 fail 结束时全额退回。
迁移清单(Replicate → hiapi)
下面这些步骤覆盖了一个典型 Replicate 集成需要改的地方。第 3、4、6 步是我们实测时真实遇到的情况。
- 盘点模型。 列出你调用的每个 Replicate 模型和版本,以及月调用量。把社区模型和私有微调单独标出来,这部分继续留在 Replicate 或另作安排。
- 为每个模型找到准确的 hiapi
modelid。 hiapi 的 id 常带路由后缀,比如/text-to-image或/image-to-video。从模型页复制,不要按 Replicate 的owner/name推导。 - id 写错会返回 400。 我们分别发送了
black-forest-labs/flux-schnell和不带后缀的flux-schnell,都返回 HTTP 400:{"error_code":"MODEL_UNAVAILABLE","message":"model not available via /v1/tasks"}。正确的 id 是flux-schnell/text-to-image。 - 显式发送 JSON。 直接
curl -d '{...}'而不加 Content-Type,curl 会按表单类型application/x-www-form-urlencoded发送,hiapi 会返回 HTTP 415UNSUPPORTED_MEDIA_TYPE。加上-H "Content-Type: application/json"即可;如果你用的 HTTP 客户端不会自动设成表单类型,也可以不带这个头。 - 按模型重新映射
input字段。 字段名在两个平台之间、不同模型之间都可能不同(例如aspect_ratio和size,整数和字符串类型的duration)。逐个对照该模型在 hiapi 文档里的参数说明。 - 每次提交都带
Idempotency-Key。 我们用同一个 key 提交了两次相同的请求体,第二次返回了原来的taskId,响应头带Idempotent-Replay: true,没有创建第二个任务。这样客户端在网络超时后重试就是安全的。 - 改写响应处理。 从创建响应里读
data.taskId,轮询GET /v1/tasks/<taskId>,当data.status为success时从data.output[].url取结果。 - 重写 webhook 接收端。 把回调地址放进顶层的
callback: {"url": "..."}字段(不要放进input),用控制台里的签名密钥校验X-HiAPI-Signature,它是timestamp + "." + body的十六进制 HMAC-SHA256,并按taskId去重。 - 重新看一下文件保留策略。 Replicate 的 API 输出一小时后就会删除,所以你很可能已经习惯拿到文件马上转存,这个习惯在 hiapi 上照样适用。我们实测中,
temp输出的expireAt在任务完成后 7 天。需要 hiapi 保存更久时,设置"storage": "persistent"。 - 并行跑一周。 先把一小部分流量切到 hiapi,用你自己的提示词对比每次成功输出的成本和端到端耗时,再整体切换。
下面是我们实测用的最简请求,密钥换成了占位符:
# 1. 提交任务(用同一个 Idempotency-Key 重试是安全的)
curl -s https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: order-42-thumbnail" \
  -d '{
    "model": "flux-schnell/text-to-image",
    "input": { "prompt": "一张极简等距插画:两台服务器机柜由一根发光的数据线相连,柔和马卡龙配色,纯白背景" }
  }'
# -> {"code":200,"data":{"taskId":"tk-hiapi-..."},"message":"success"}

# 2. 轮询,直到 data.status 为 "success" 或 "fail"
curl -s https://api.hiapi.ai/v1/tasks/tk-hiapi-... \
  -H "Authorization: Bearer $HIAPI_API_KEY"
# -> data.output[0] = {"type":"image","url":"https://temp.hiapi.ai/...jpg","expireAt":<unix 秒>, ...}
完整约定(状态枚举、错误码、回调签名、重试策略)见 异步 API 介绍文档。
怎么选
适合选 hiapi 的情况:
- 你的业务主要调用主流商用图像和视频模型,希望所有模型用同一种请求格式。
- 你希望按输出计价,费用不随 GPU 类型或运行时长波动。
- 你需要 API 内置的提交幂等和失败退款。
- 团队同时需要文本模型,或者需要中文文档,希望放在同一个账号下。
适合留在 Replicate 的情况:
- 你在跑社区模型、锁定特定版本,或者部署自己的模型和微调。
- 你依赖流式
output/logswebhook,或Prefer: wait同步模式。 - 你用的那几个模型在 Replicate 上更便宜。就 FLUX1.1 [pro] 和 FLUX.1 [schnell] 来说,目前确实如此。
- 模型发现、快速试用大量开源模型,对你来说比精简的模型清单更重要。
很多团队最后两边都用:Replicate 用来做实验和跑自定义模型,少数几个高调用量的商用模型交给一个生产供应商。
常见问题
hiapi 适合作为 Replicate 的替代方案吗? 如果你主要调用 FLUX、Nano Banana、GPT Image、Kling、Seedance、Veo 这类商用图像和视频模型,想要一套异步 API 和按输出计费,是合适的。它不能替代社区模型或你自己的微调。
Replicate 和 hiapi 哪个更便宜? 看模型。在两边都公布单张价格的两个 FLUX 模型上,Replicate 更便宜。其他模型请用双方当前的定价,拿你自己的高调用量模型逐个比。另外,Replicate 按时长计费的模型费用会随运行时间变化,hiapi 则是每次输出固定价格。
怎么从 Replicate 迁移到 hiapi?
把每个模型对应到准确的 hiapi model id,接口改成 POST https://api.hiapi.ai/v1/tasks,按模型重新映射 input 字段,状态判断改成 success/fail,再按 hiapi 的终态签名回调重写 webhook 接收端。上面的清单列出了全部 10 步。
hiapi 有类似 Replicate 的 webhook 吗?
有,但只在终态触发。在创建请求的顶层设置 callback.url,任务成功或失败时 hiapi 推送一次,投递失败最多共尝试 4 次,并可用 HMAC-SHA256 签名。没有 start、output、logs 这类过程事件。
输出文件能保存多久?
Replicate 默认在一小时后删除 API 预测数据,包括输出文件。hiapi 的 temp 输出默认保留约 7 天,使用 persistent 存储可以更久。无论用哪家,需要长期保存的文件都应该自己下载转存。
结论
模型广度、自定义模型和流式进度事件,Replicate 更合适。如果生产流量集中在少数几个商用图像和视频模型上,hiapi 更省事:一个接口、五个状态值、按输出定价,外加内置幂等。最快的判断办法是先迁移调用量最大的那个模型:在 hiapi 模型页找到它的 id,用你自己的提示词跑一遍上面的 curl,再和你现在的成本、耗时对比。想动手试,可以先 注册一个免费 HiAPI key。