台词配音
一张横版人像,生成 1080p 讲解视频
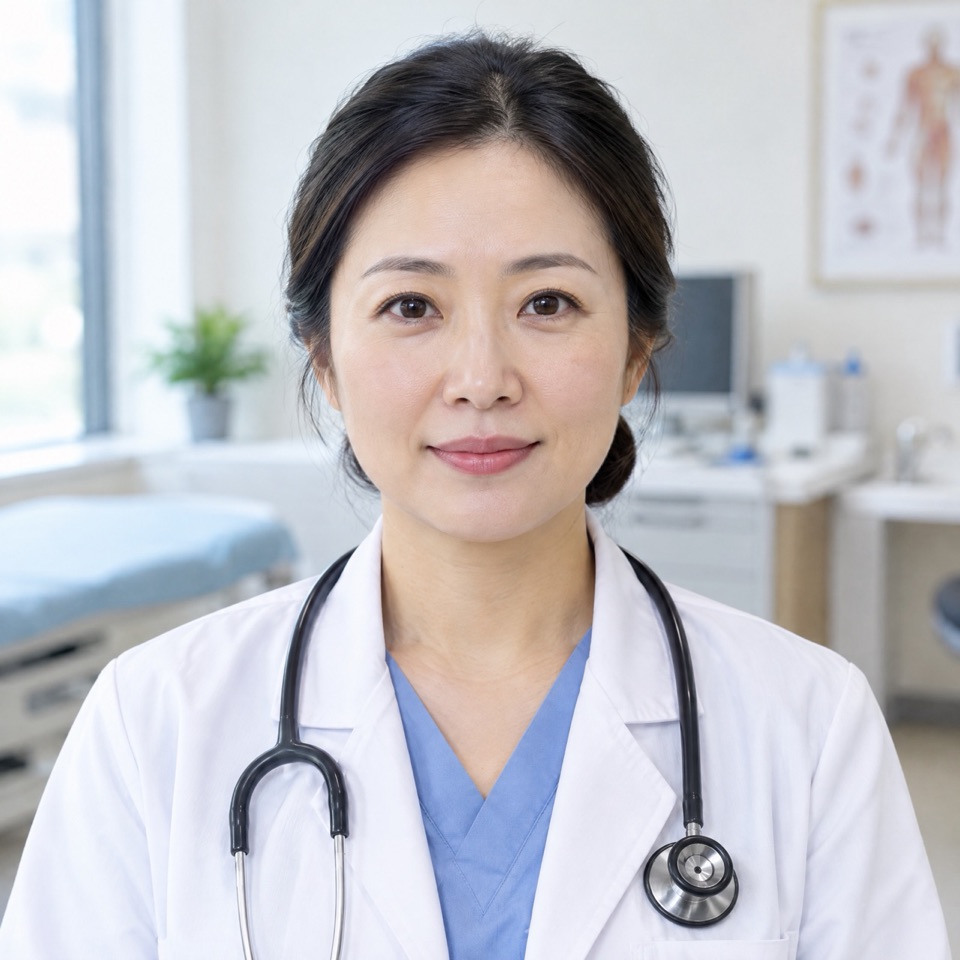
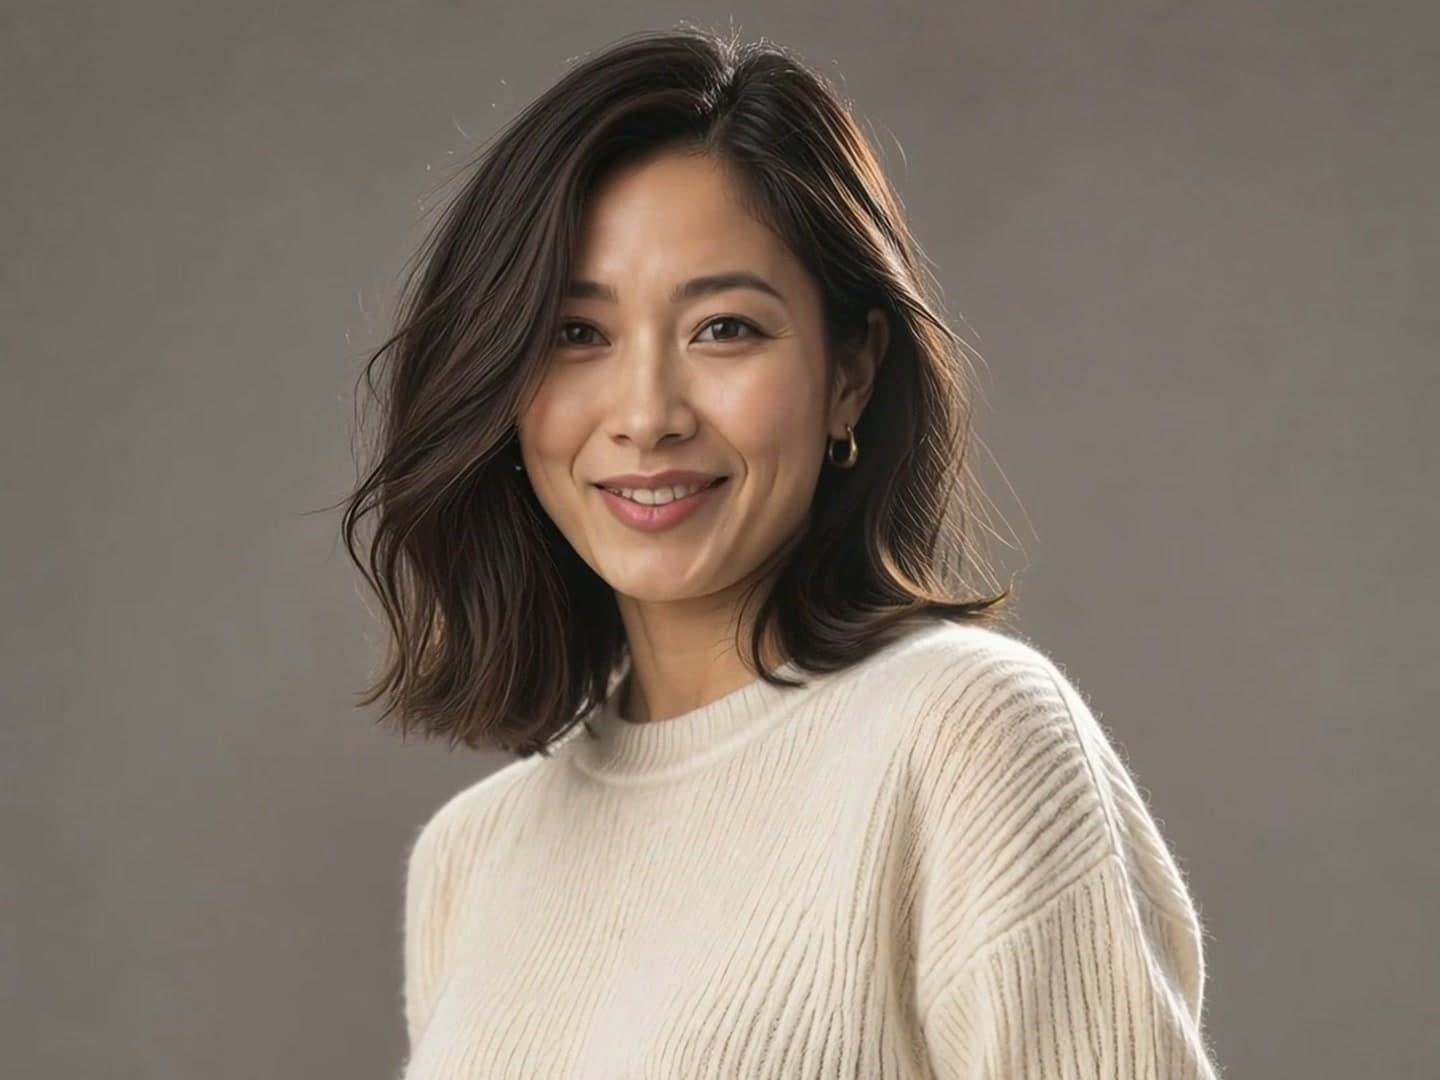
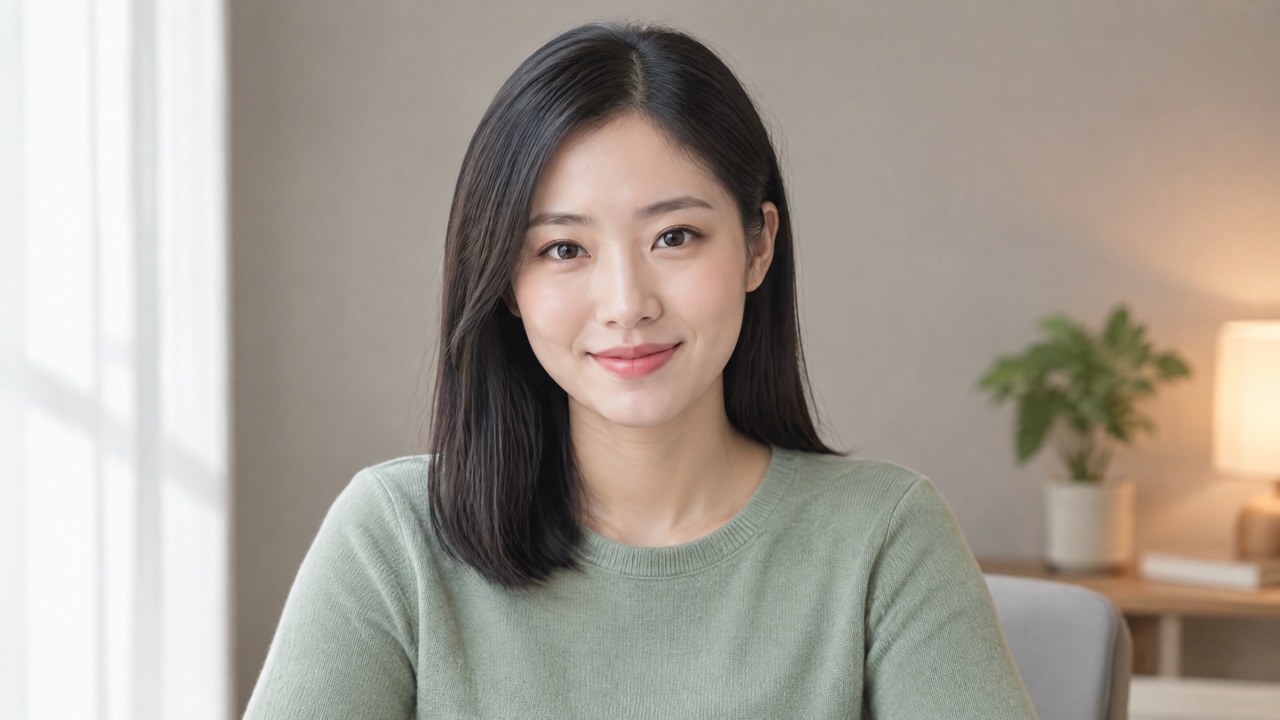
照片提供人物和场景,台词与预置声音决定说什么、怎么说。输出保留照片里的毛衣、发型和背景,口型、眨眼和轻微点头随语音自然变化。
台词
Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.
HeyGen Avatar IV API:上传一张人像照片,用台词或自己的音频驱动开口说话,口型自然同步,适合产品讲解、课程录制和短视频口播,可在线试用并查看实时价格。
提供商: HeyGen
类型: 视频生成
接口: /v1/tasks
状态: 已开放
消耗: 查看页面实时价格
HeyGen Avatar IV API:上传一张人像照片,用台词或自己的音频驱动开口说话,口型自然同步,适合产品讲解、课程录制和短视频口播,可在线试用并查看实时价格。
定价
标准用量
模型参数暂时无法加载
为避免提交不完整请求,完整参数恢复前不会显示半套表单。
用图片控制视频的开始和结束画面。
准备生成
配置参数并点击"运行"查看输出结果。
看照片里的人如何按台词或录音开口,口型、眨眼和点头怎样跟随语音,以及照片比例和输出画幅不同时画面如何填充。
台词配音
照片提供人物和场景,台词与预置声音决定说什么、怎么说。输出保留照片里的毛衣、发型和背景,口型、眨眼和轻微点头随语音自然变化。
台词
Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.
竖版口播
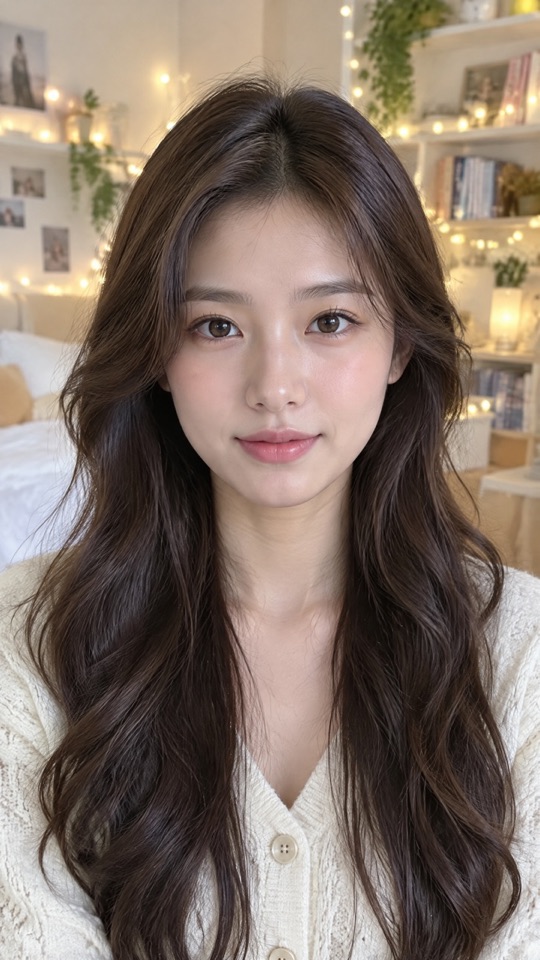
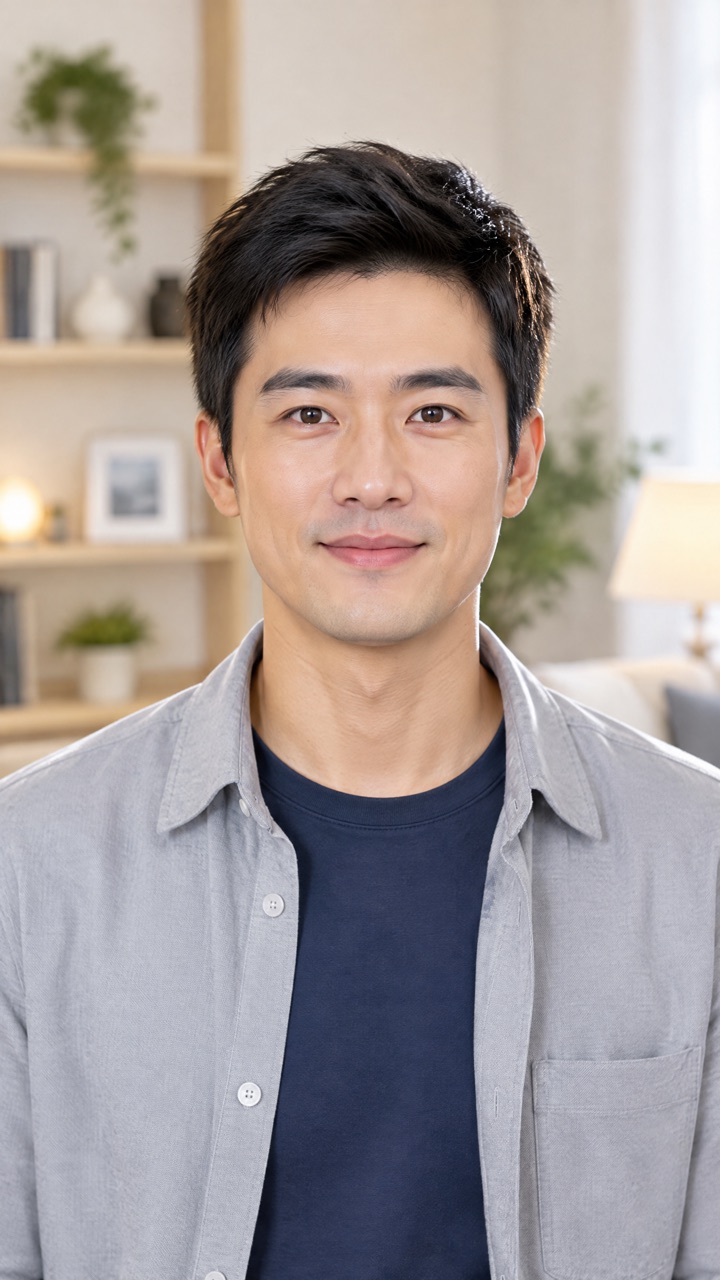
照片本身就是 9:16,输出同样选 9:16,画面不留白。适合把达人或店员照片做成新品介绍、种草类短视频口播。
台词
I've been using these new earbuds for a week. The noise canceling is super quiet, and the battery lasts all day. Follow me for more.

商务讲解
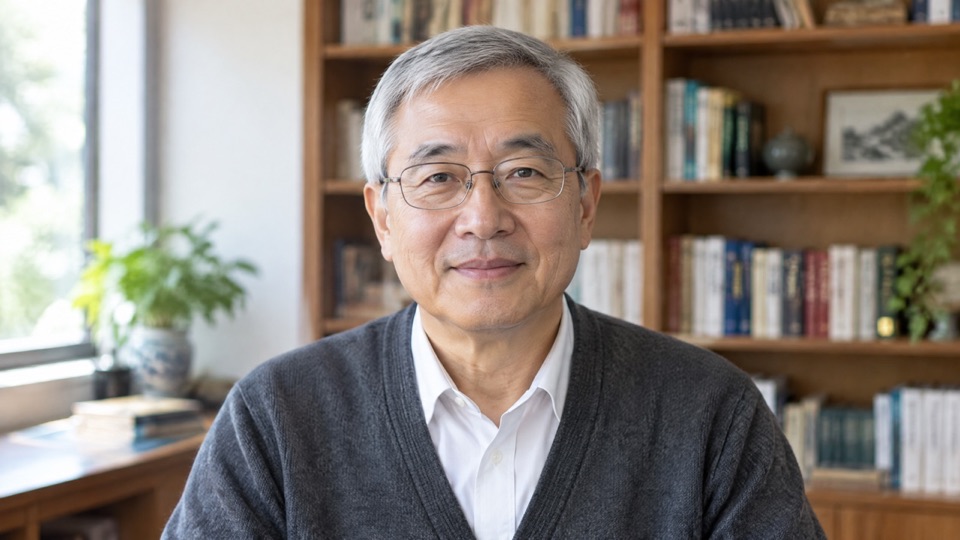
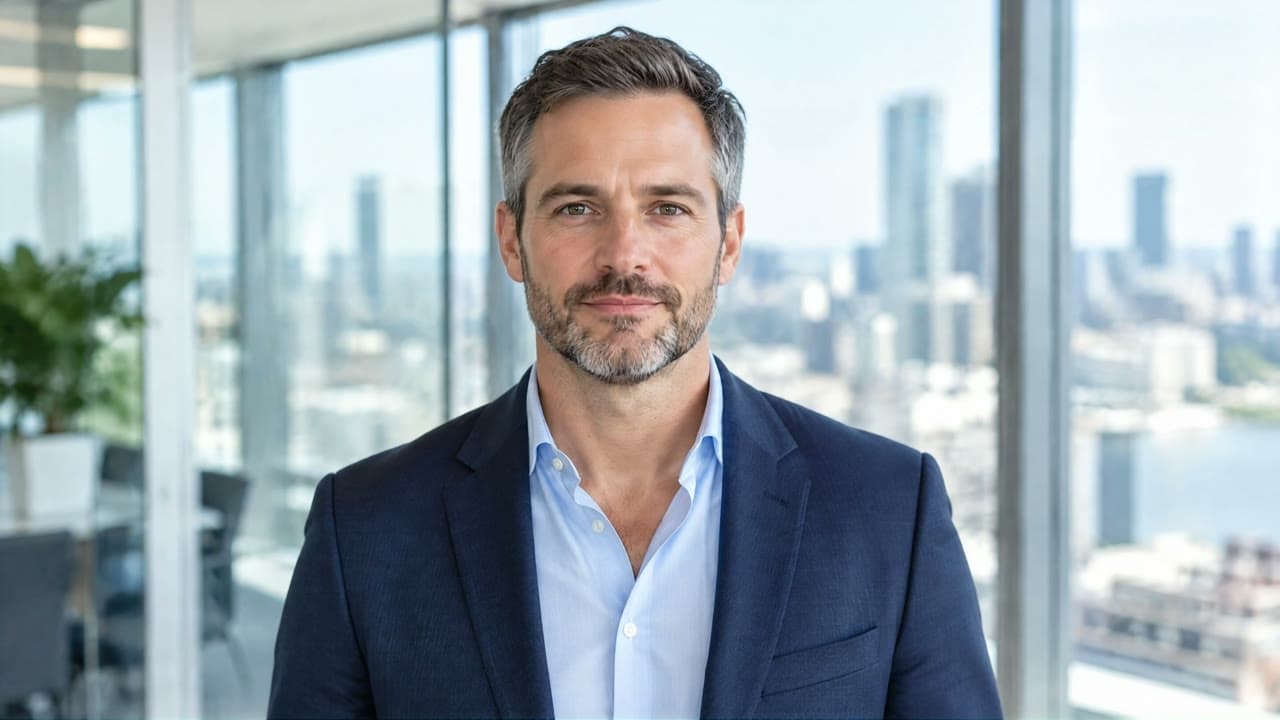
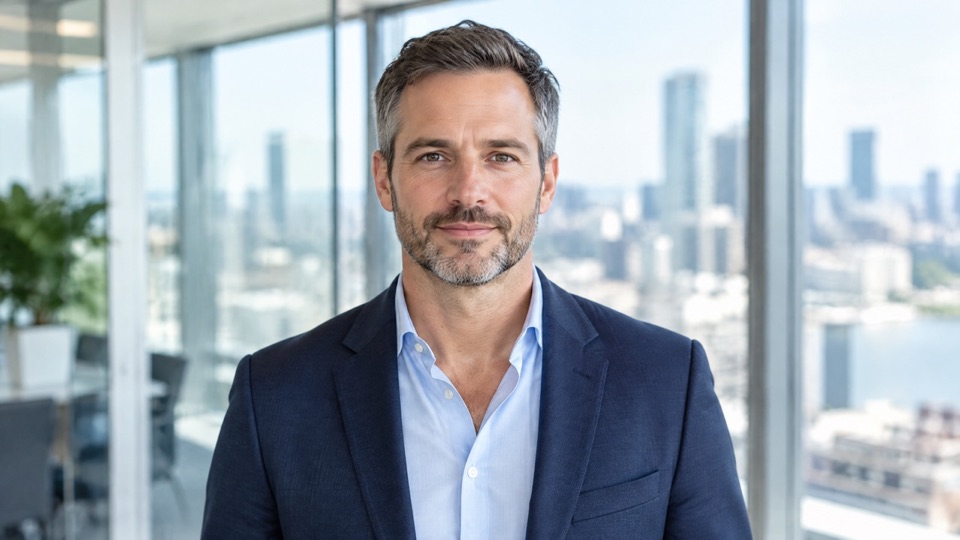
办公室背景的半身照,配一个稳重的男声,做成季度汇报或方案讲解。台词更新后重新生成即可,不用每次重新录制。
台词
Hi, I'm Daniel. Send me your quarterly numbers, and I'll walk your team through what changed and what to do next.

1:1 方形
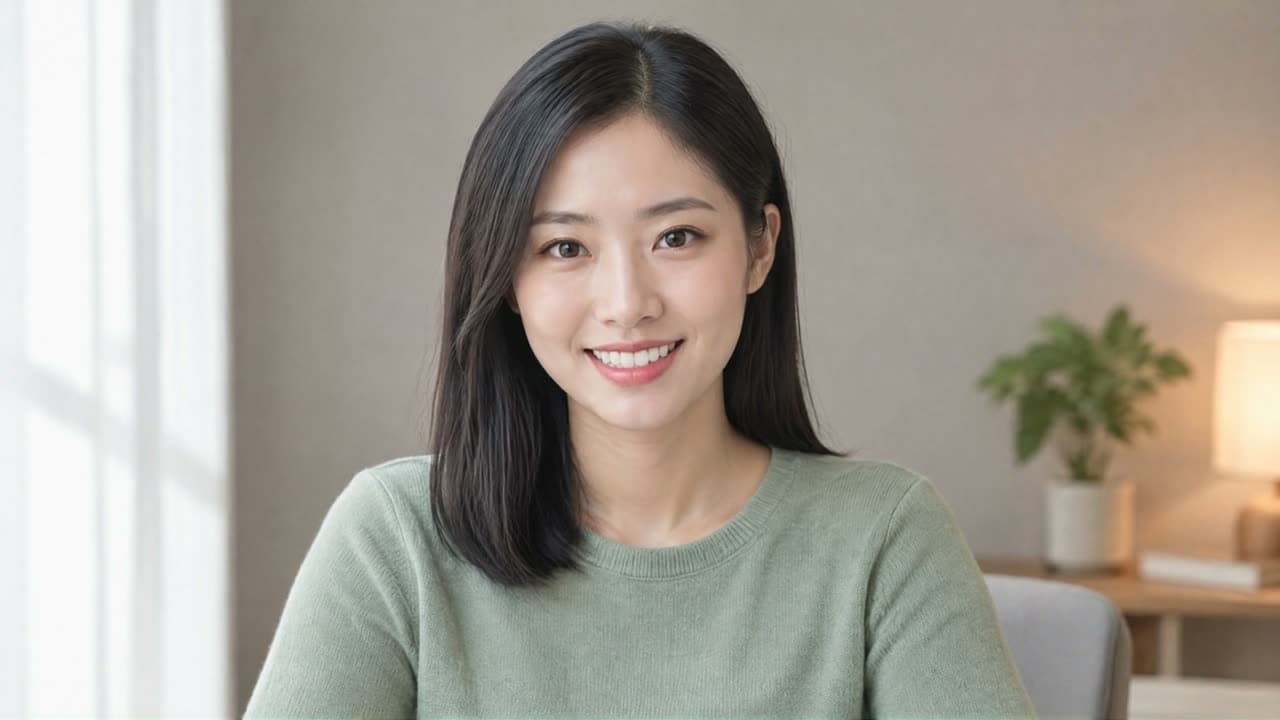
照片和输出都是 1:1,适合信息流和社群里的方形视频。选一个语气平稳的声音,更贴合科普和提醒类内容。
台词
When the seasons change, mornings get chilly, so bring a jacket. If a cough lasts more than a week, please come see us at the clinic.

音频驱动
不写台词,直接上传录音,口型和停顿都跟着录音走。竖版照片配 9:16 输出,画面没有留白。
驱动音频
一段约 10 秒的英文录音,口型跟着录音走。

3D 角色
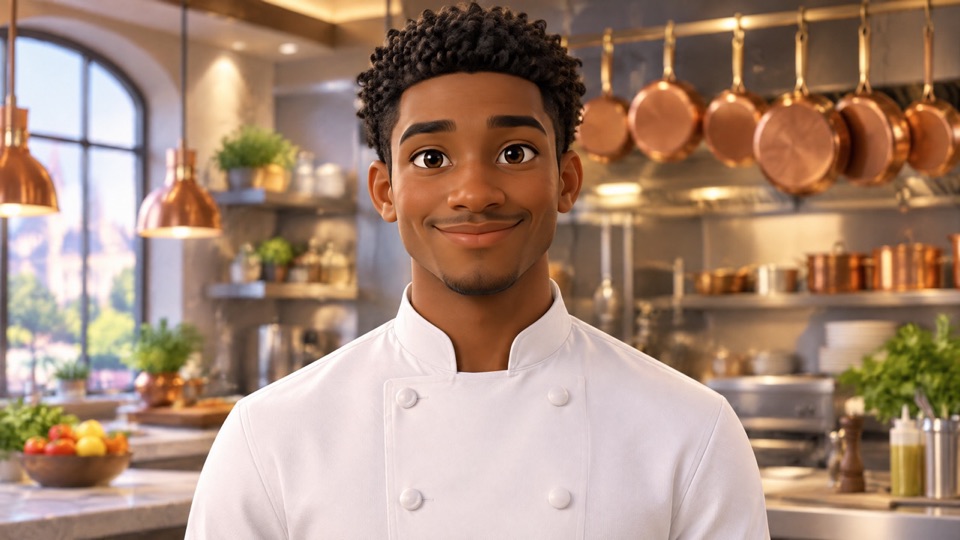
输入不一定是真人照片,插画或 3D 渲染的人物形象也可以,只要有一张清晰的人脸。适合品牌虚拟形象、卡通讲师等内容。
台词
Tonight's special is a slow-roasted tomato soup. It's simple, warm, and ready in twenty minutes. Let's cook!

图片背景
照片是 16:9,输出选 9:16,人像以外的区域用指定的背景图填充。这里用一张黑板图,把老师的讲解做成课程风格的竖屏视频。
台词
Hello everyone. Today we'll explain the Pythagorean theorem in five minutes. In a right triangle, the squares of the two legs add up to the square of the hypotenuse.

需要预置数字人、整段动作迁移或普通图生视频时,HiAPI 上还有这些模型可选。
提供商
输入照片
驱动方式
画幅
分辨率
背景
输出
接口
价格
三步把一张照片变成说话视频:准备照片、决定说什么、提交任务。先用 720p 和一句短台词验证效果,再出正式版本。
选正脸清晰、五官无遮挡、光线均匀的单人照片,作为 image_url。
台词配音:填 prompt 并选 voice。音频驱动:只传 audio_url。再按投放位置选画幅,画幅和照片不同时可设置背景。
通过 heygen-avatar-iv 创建异步任务,用 callback.url 或 GET /v1/tasks/:id 获取结果,费用按实际秒数结算。
一个 POST /v1/tasks 请求即可提交照片数字人视频任务;完整参数、回调与错误处理见 API 文档。
curl -X POST "https://api.hiapi.ai/v1/tasks" \
-H "Authorization: Bearer YOUR_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "heygen-avatar-iv",
"input": {
"image_url": "https://example.com/portrait.png",
"prompt": "Hi, I'm Lin. With one photo and a short script, I can present your product or record a lesson, with natural lip-sync and expressions.",
"voice": "Cute Chloe - Friendly",
"resolution": "1080p",
"aspect_ratio": "16:9"
}
}'HEYGEN AVATAR IV API
HeyGen Avatar IV 是 HeyGen 的照片数字人引擎:上传一张正脸清晰的人像,再给一段台词或一段音频,就能得到这个人开口说话的视频。不需要先录真人素材、也不需要训练专属形象,照片本身就是出镜人。
照片决定人物长相、服装和所在场景,台词或音频决定说什么和说话节奏。模型负责口型同步,并补上眨眼、点头和自然的面部动作,让静态照片看起来像在镜头前讲话。
它适合手里已有讲师、代言人或店员照片,需要持续产出讲解、培训和口播视频的团队。台词改了只需重新生成,不用重新约人拍摄。
从选照片、决定说什么,到让画面适配投放位置,分别看 Avatar IV 的表现。
01
Avatar IV 直接驱动你上传的照片,而不是换成模型自带的形象。照片里的发型、衣服、背景和光线都会保留到视频里,适合让品牌代言人、讲师或店员用自己的形象出镜。
照片越清晰效果越稳:正脸、五官无遮挡、光线均匀、嘴巴自然闭合最理想;侧脸、戴口罩或多人合照不适合。插画和 3D 角色同样可以,但需要一张清晰的人脸,动物等非人类形象可能无法识别。
02
台词配音:填一段文字(中文、英文都可以),从 102 个预置声音里选一个,系统生成配音并同步口型,适合批量制作讲解和通知类视频。不选声音时使用默认的 Warm Pro Narrator。
音频驱动:上传已有录音(最长 600 秒),口型直接跟着录音走,适合要保留本人声音、方言或专业配音的内容。两种方式每次只能选一种。
03
输出支持 16:9、9:16、4:5、5:4、1:1 和 auto,auto 沿用照片本身的比例。分辨率可选 720p 或 1080p。
当选的画幅和照片比例不同,人像以外的区域会被填充:可以指定纯色或一张背景图,不指定时为白色。这样一张横版照片也能直接投放到竖屏信息流。
用客服或产品经理的照片批量生成功能介绍、操作说明和常见问题解答视频,文字更新后重新生成即可。
讲师只需提供一张照片和讲稿,就能产出章节导读、知识点讲解等短视频,减少反复录制。
竖版照片配 9:16 输出,直接做成种草、新品介绍类口播素材,适合多账号、多语种批量投放。
已有播客片段、方言配音或专业录音时,用音频驱动让照片里的人开口,声音完全是你提供的那段。
三个模型都能让人物开口或动起来,区别在于出镜人从哪里来、动作由什么决定。
HeyGen Avatar IV
你有一张自己的人像照片,想让照片里的人开口讲话。
HeyGen Avatar V
不需要自己的形象,从 497 个预置数字人里挑一个出镜,并需要透明背景或 SRT 字幕。
Kling 3.0 Motion Control
要把一段参考视频里的动作、手势和舞步迁移到照片人物身上,而不只是说话。
在 HiAPI 上,每条生成的视频、对应的参数和费用都会记在你的账户里,方便回看效果、复用参数和核对开支。
生成的视频可在产物记录中查看和下载,方便挑出效果最好的一版用于剪辑和投放。
费用按生成视频的实际秒数结算,失败任务全额退回,每笔消费都能在用量记录里查到。
同一个 Key 也能调用图像、语音和其他视频模型,方便先生成人像再做口播。
一张人像照片,再选一种驱动方式:输入台词并选择声音,或上传一段音频。用台词时不选声音,会使用默认声音 Warm Pro Narrator。
正脸、五官清晰无遮挡、光线均匀、嘴巴自然闭合的单人照片效果最稳。侧脸、戴口罩、多人合照或面部很小的照片不适合。
不需要传时长。台词配音时长度由台词和语速决定;音频驱动时与上传的音频长度一致,音频最长 600 秒。
画幅支持 16:9、9:16、4:5、5:4、1:1 和 auto(沿用照片比例);分辨率支持 720p 和 1080p。
只有输出画幅和照片比例不同、画面出现留白时,背景才会显示。可以选纯色(#RRGGBB)或一张背景图,不设置时为白色。
Avatar IV 驱动你自己上传的照片;Avatar V 从 497 个预置数字人里选择形象,并额外支持透明背景 WebM、移除背景和 SRT 字幕。
按生成视频的实际秒数计费。创建任务时按估算时长预扣,完成后按实际秒数结算,失败任务全额退回;单价见本页实时价格。