下面每条都是 OmniHuman 1.5 的真实成片,说什么、说多久,全部由驱动音频决定。
1. 横版口播:产品讲解
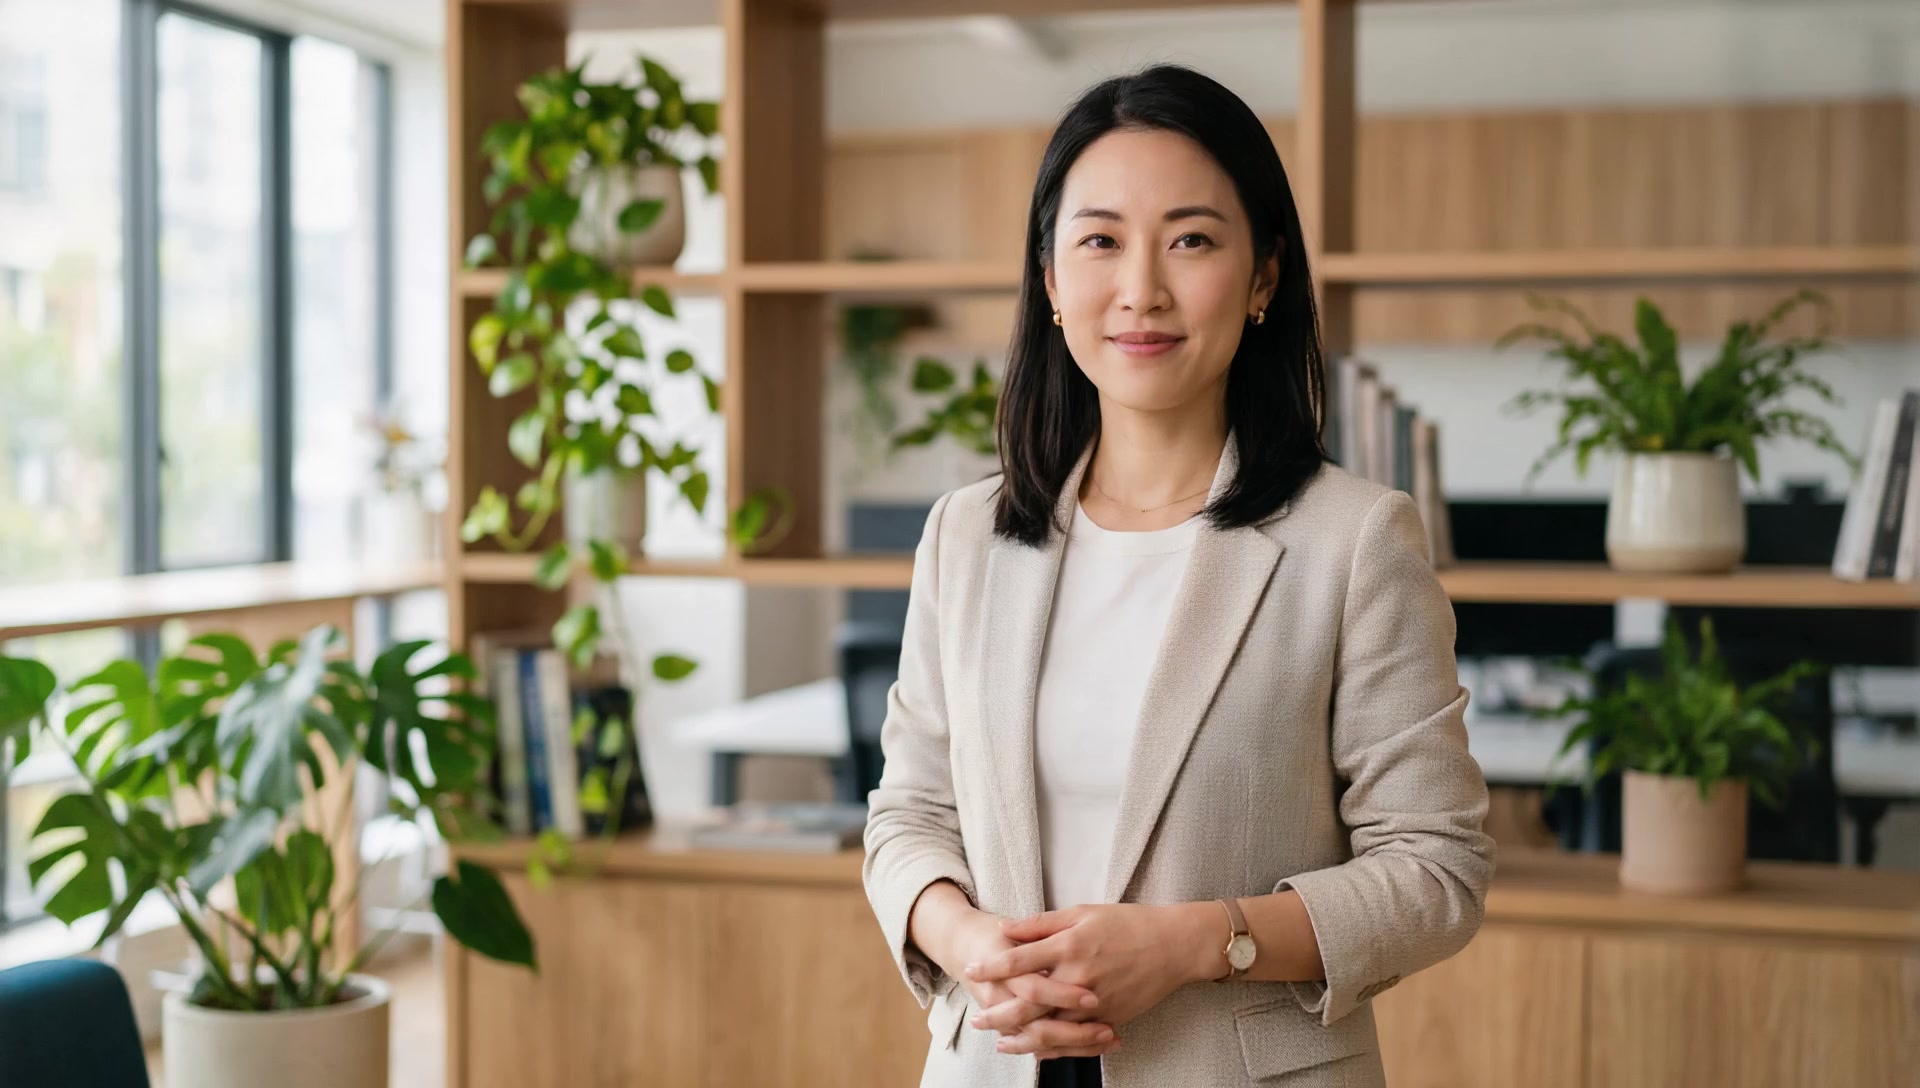
参数:16:9 横版半身照 · 1080p · 8 秒 · $1.544 · 看 MP4 →
注意双手在功能点上打开,点头落在句子之间,而不是每个词都点。
自然地微笑讲话,说到功能时双手轻轻打开做手势,偶尔点头
三句写清三层:表情、绑在台词上的一个手势、一个「偶尔」的小动作。声音的部分不用写,音频里已经有了。
2. 宠物主播:1:1 新闻画面
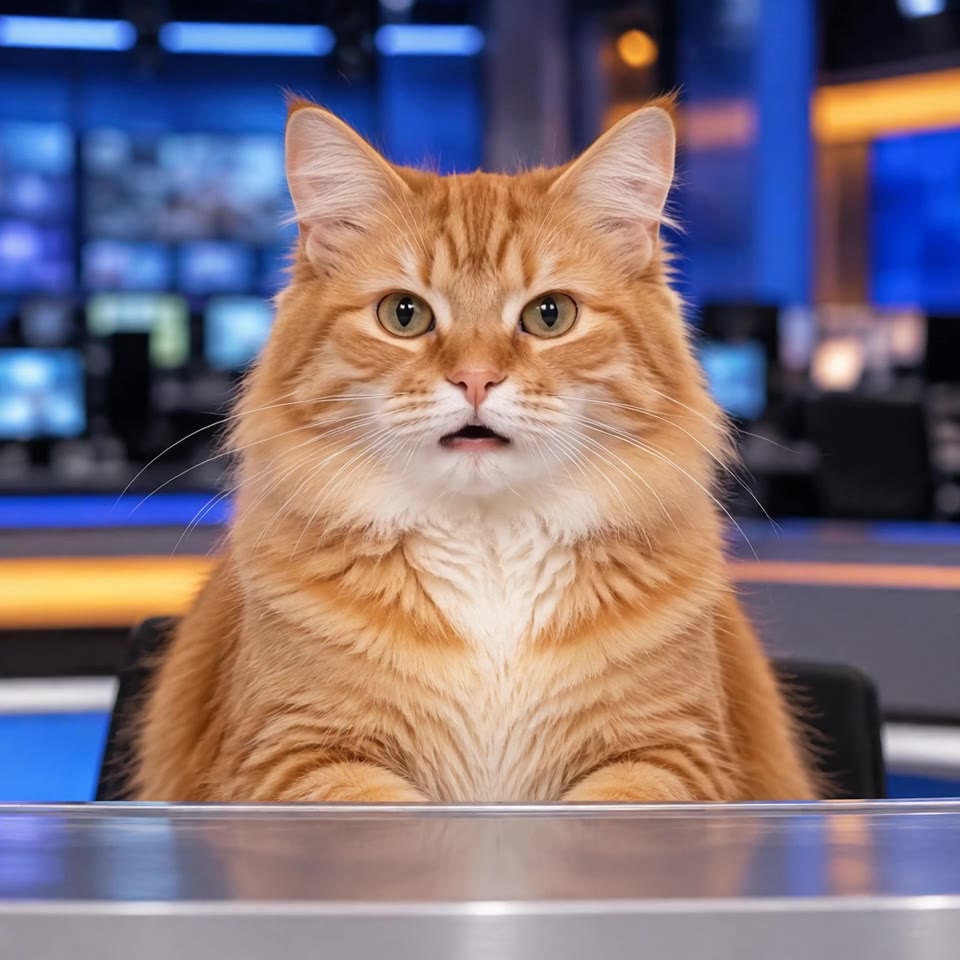
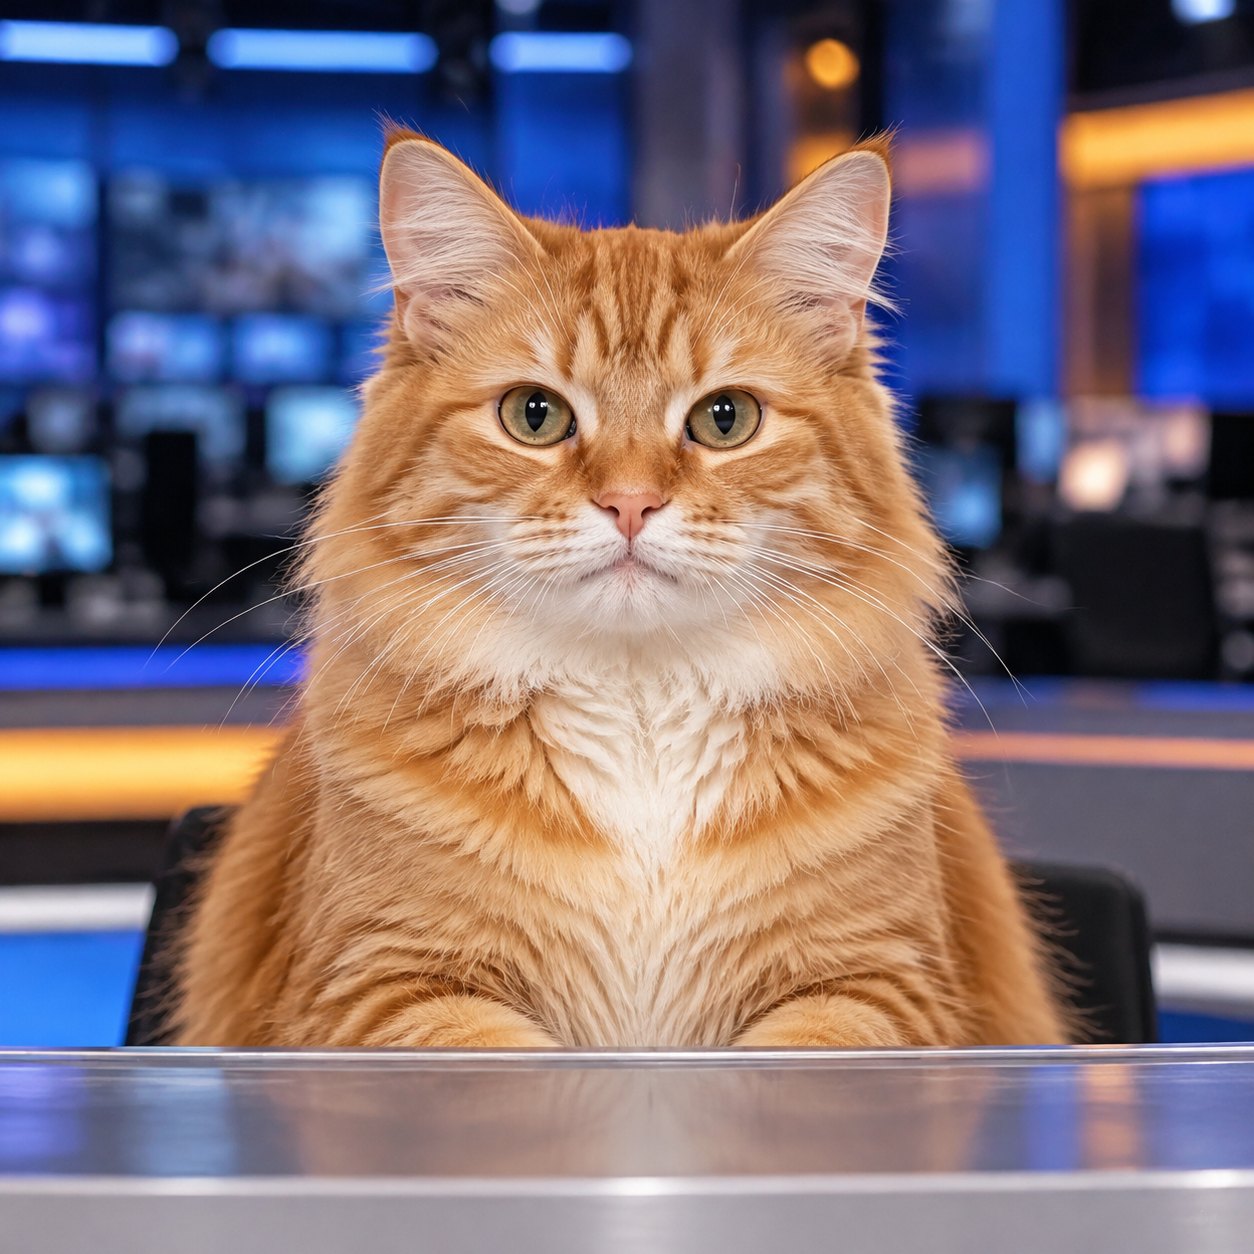
参数:1:1 猫主播图 · 720p · 8 秒 · $1.544 · 看 MP4 → 素材:猫人像
猫从头到尾看着镜头,动作都落在脸上:耳朵轻动和眨眼,没有手可以比划。
对着镜头自然地播报新闻,说话时耳朵轻动,偶尔眨眼
句式照搬真人主播,只把手势换成了猫做得到的动作。「对着镜头」锁住视线,「自然地」让播报节奏不僵。
3. 全身动作:9:16 讲解
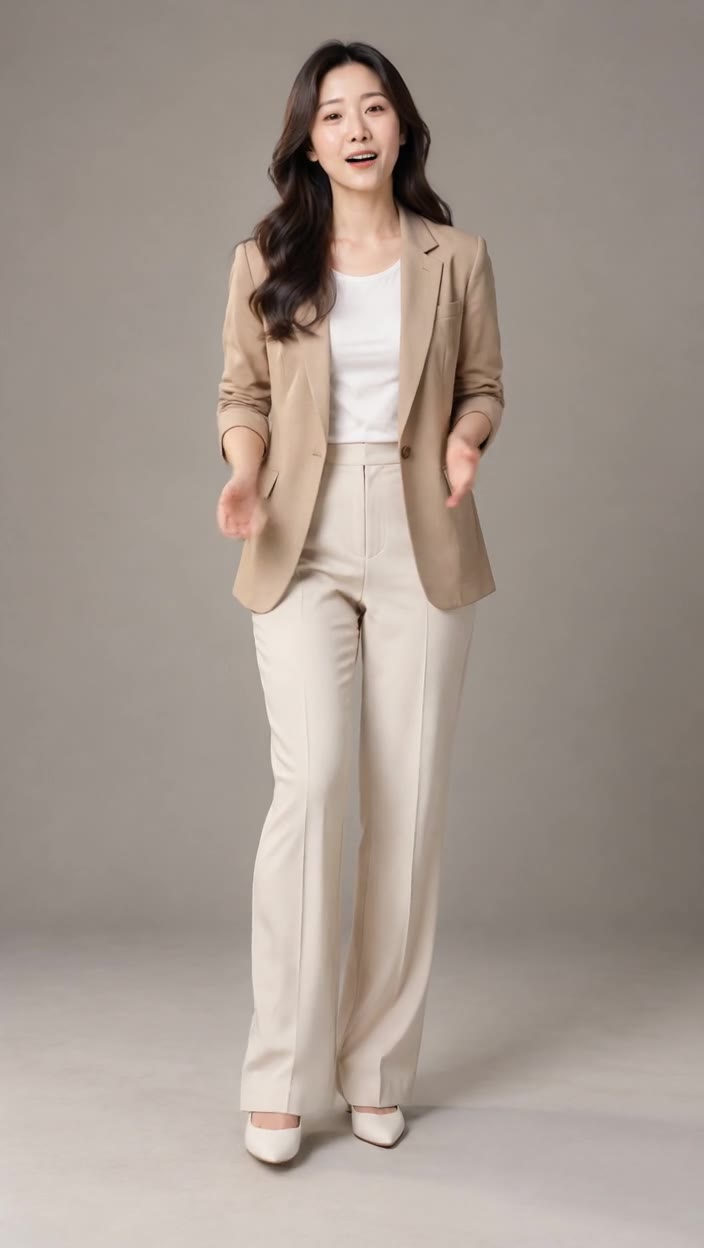
参数:9:16 全身照 · 720p · 8 秒 · $1.544 · 看 MP4 →
全身画面里双手有活动空间,同样三句话,成片更像在讲解,而不是一个只动嘴的头像。
自然微笑讲话,双手随着讲解轻轻打开做手势,偶尔点头
「随着讲解」把手势绑在讲解节奏上,不是固定循环;「偶尔点头」给头部一个慢半拍的二次动作,上半身不会僵住。
4. 英文介绍:同一张人像,换一种语言
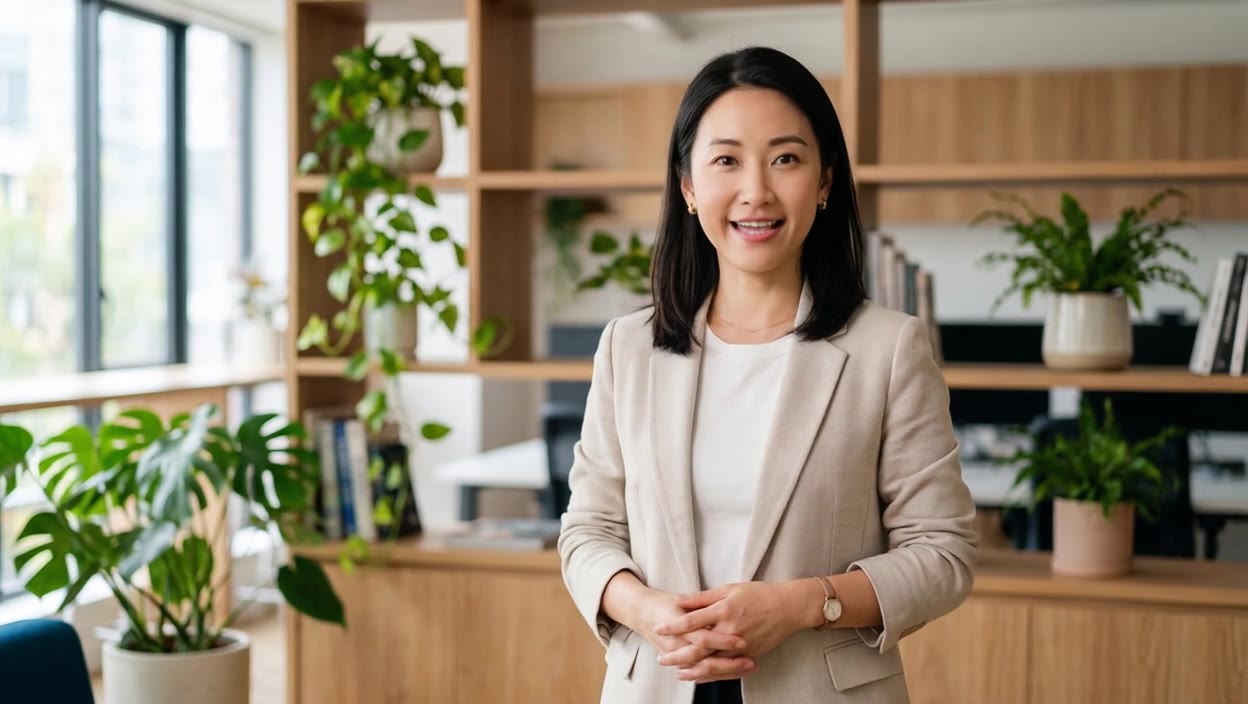
参数:16:9 横版人像(与案例 1 同一张) · 720p · 7.5 秒音频,按 8 秒结算 · $1.544 · 看 MP4 →
英文语速比中文快,三个动作还是落在该落的地方:轻微微笑、说重点时打开双手、偶尔点头。
Speak naturally to camera with a slight smile, open your hands when making a point, and nod occasionally.
提示词里没提语言,只写了动作。同一张人像,从中文录音换到英文录音,这三拍照样成立。
5. 多人蒙版:三人画面里指定一个人说话
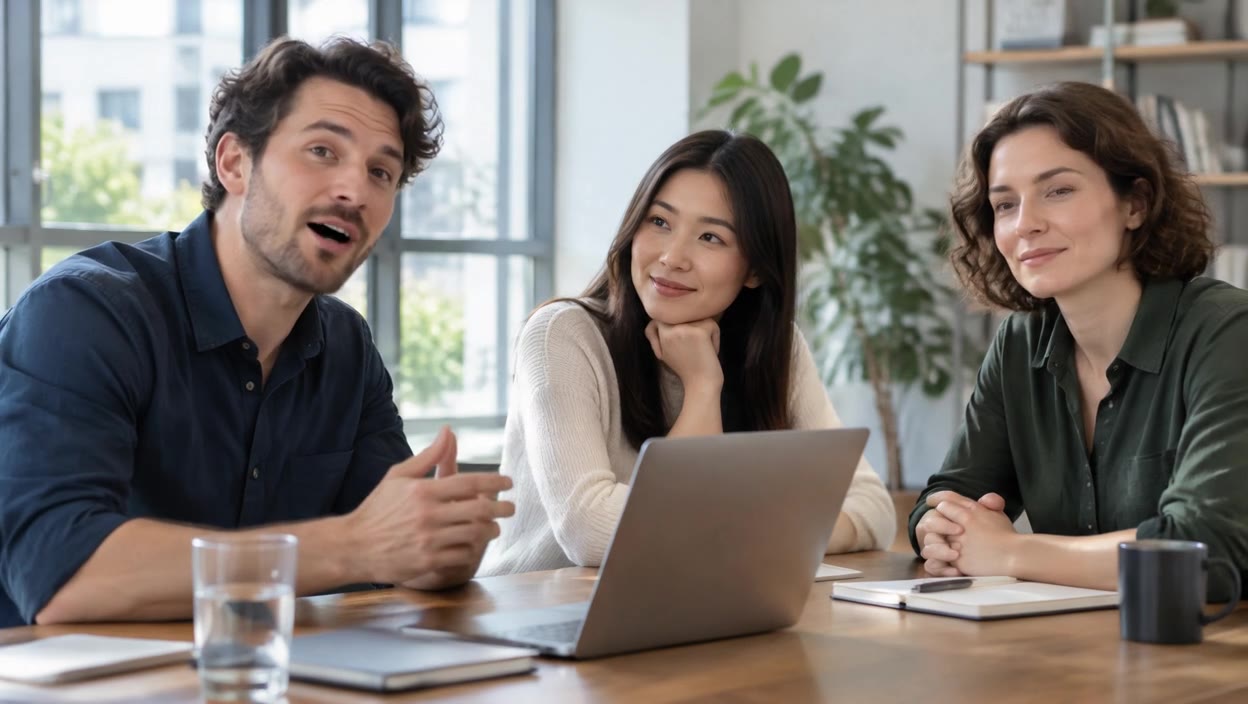
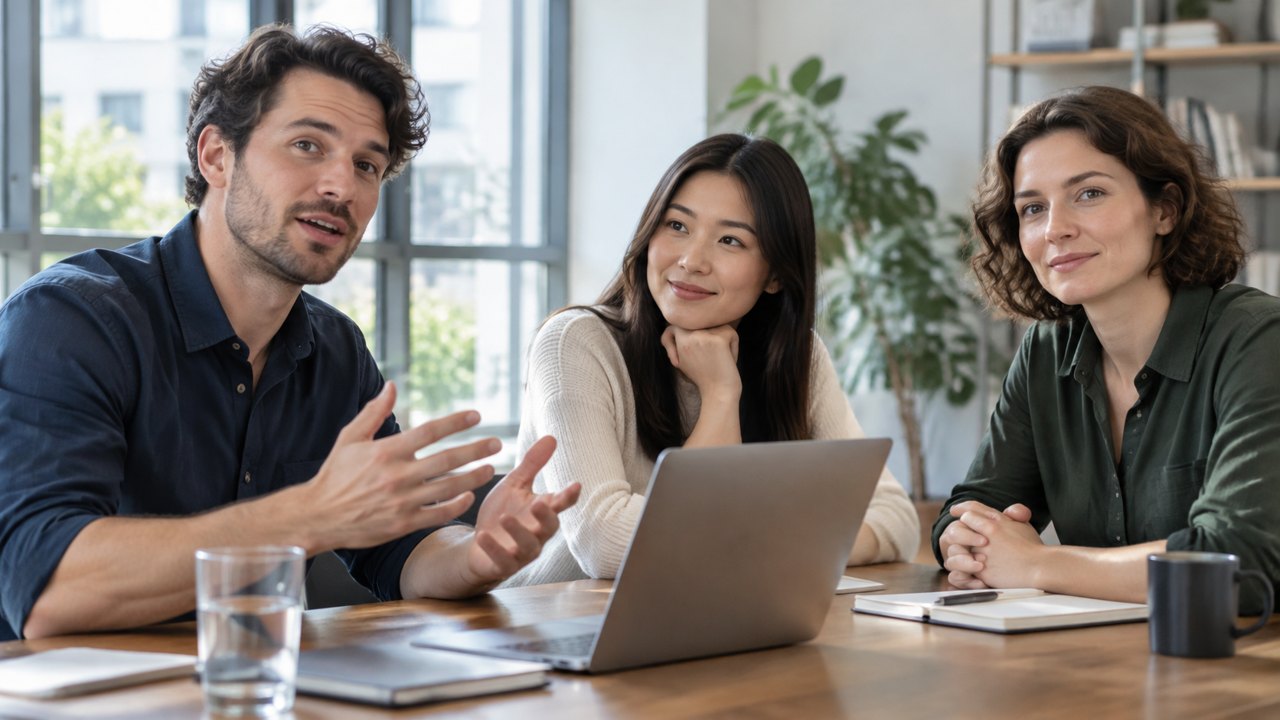
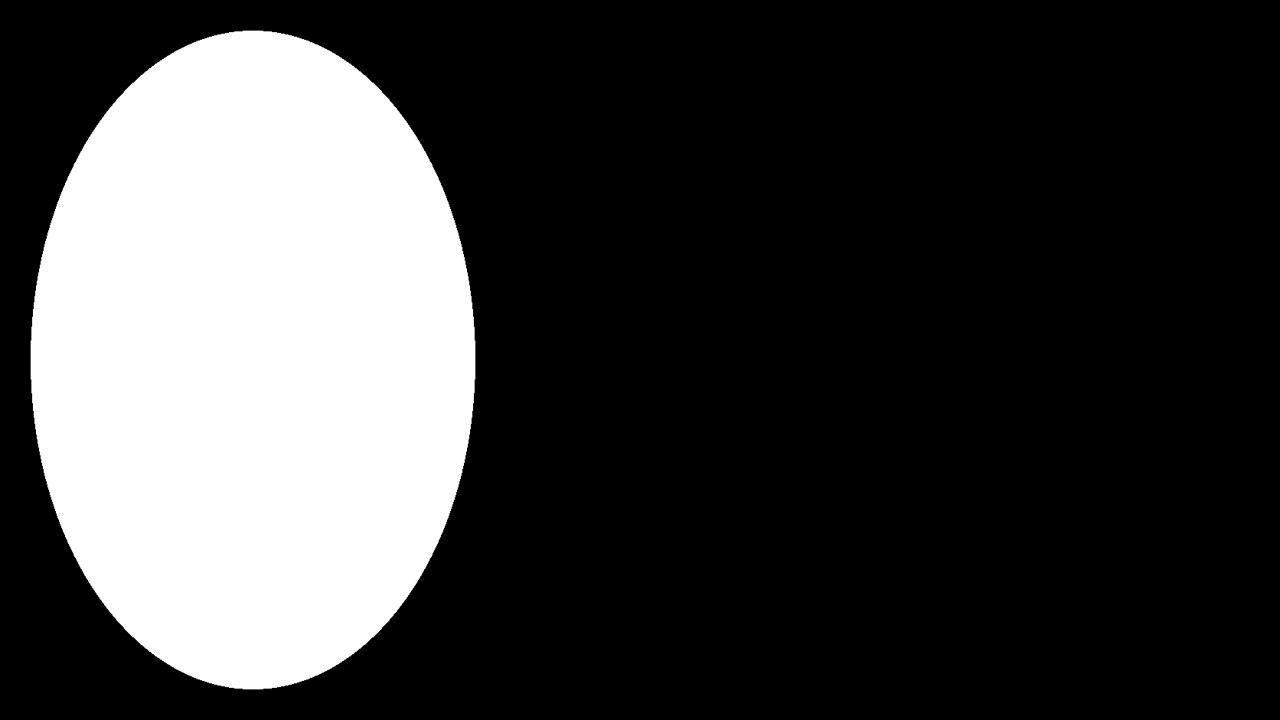
参数:16:9 三人会议图 · 同尺寸蒙版(左侧男士为白) · 720p · 8 秒 · $1.544 · 看 MP4 → 素材:会议人像 · 蒙版
蒙版决定谁可以开口,提示词负责告诉另外两个人脸上该有什么反应。
只有左侧的男士开口说话,中间和右侧的两位保持微笑聆听,身体轻微自然移动
前半句用文字复述蒙版:只有左侧的男士说话;后半句给中间和右侧的人分配任务——微笑、聆听、身体轻微移动。画面不会只剩一个人在动,也不会有人抢话。
怎么写自己的提示词
- 按「表情 → 手势 → 镜头」写,一句一项就够。
- 控制在 300 字符以内,中文、英文、日文、韩文、西班牙文、印尼文都能写;音频决定时长,先剪好音频再决定生成多长。
- 多人画面先做蒙版,再写提示词:说清谁开口,以及其他人在做什么。
挑一张接近自己素材的人像,配一段 15 秒以内的录音,把上面任意一条提示词粘进去。打开 OmniHuman 1.5 模型页 →
相关阅读:OmniHuman 1.5 价格 · vs HeyGen Avatar IV · API 接入教程