音频驱动
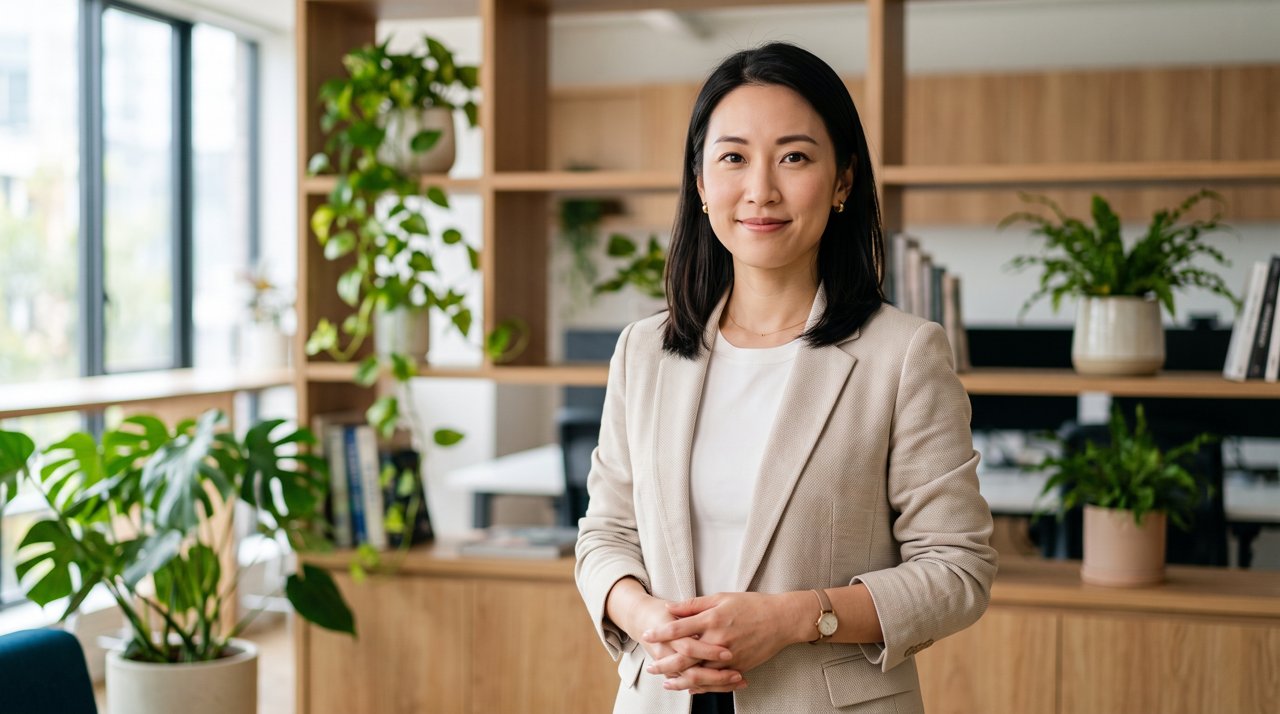
一张横版半身照,变成新品发布口播
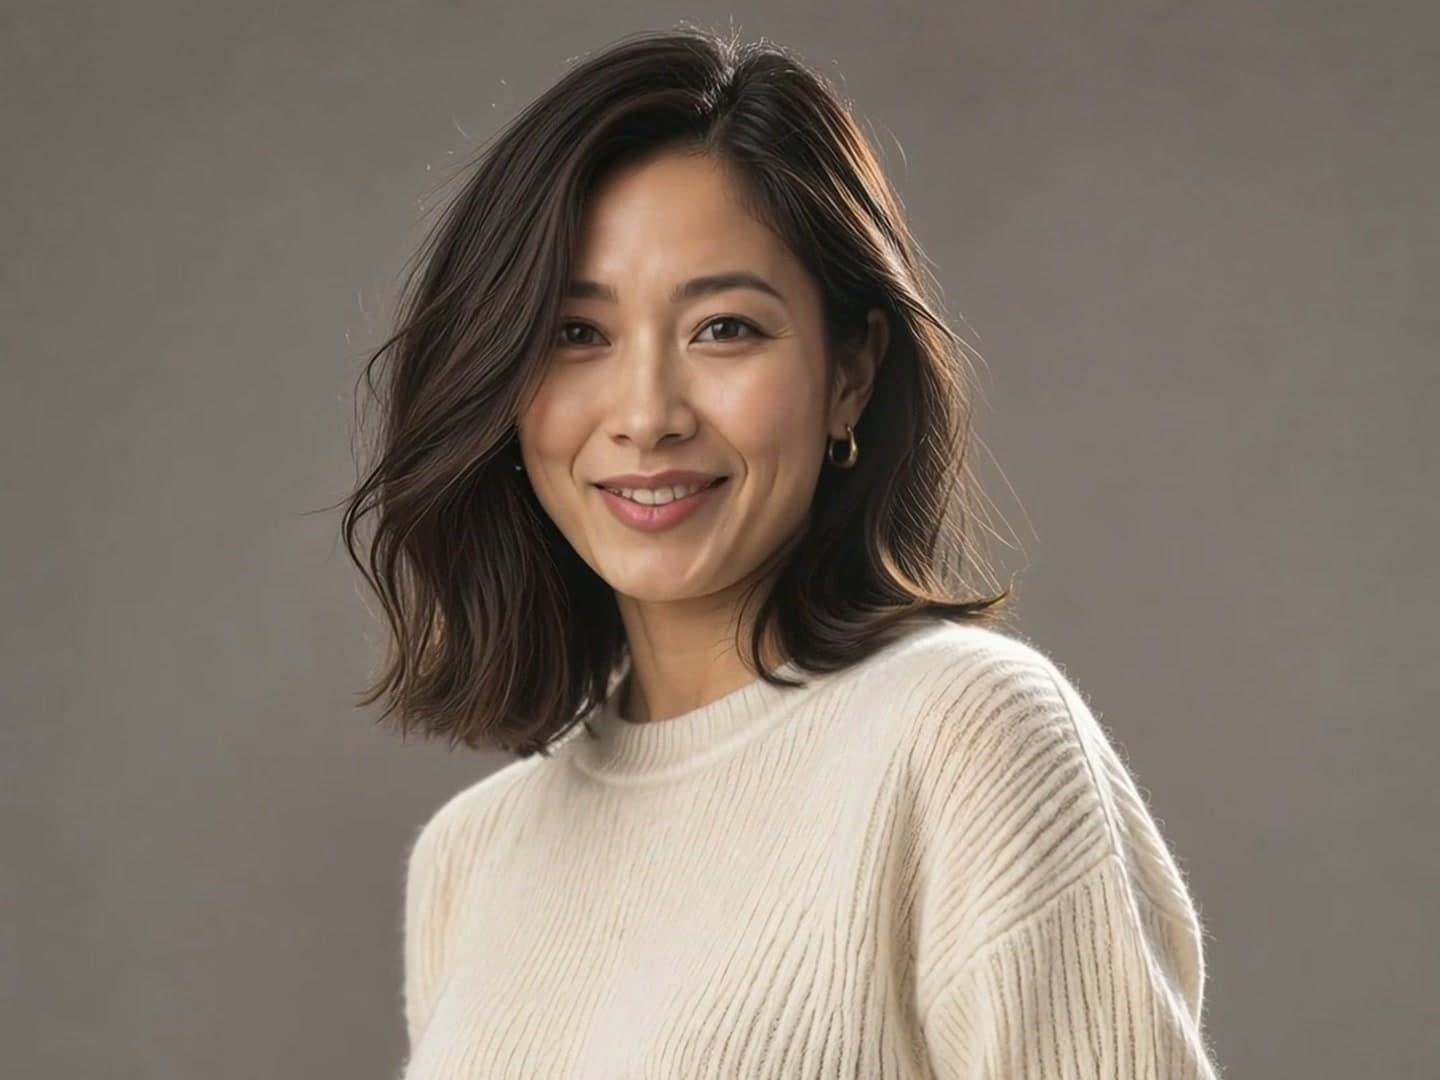
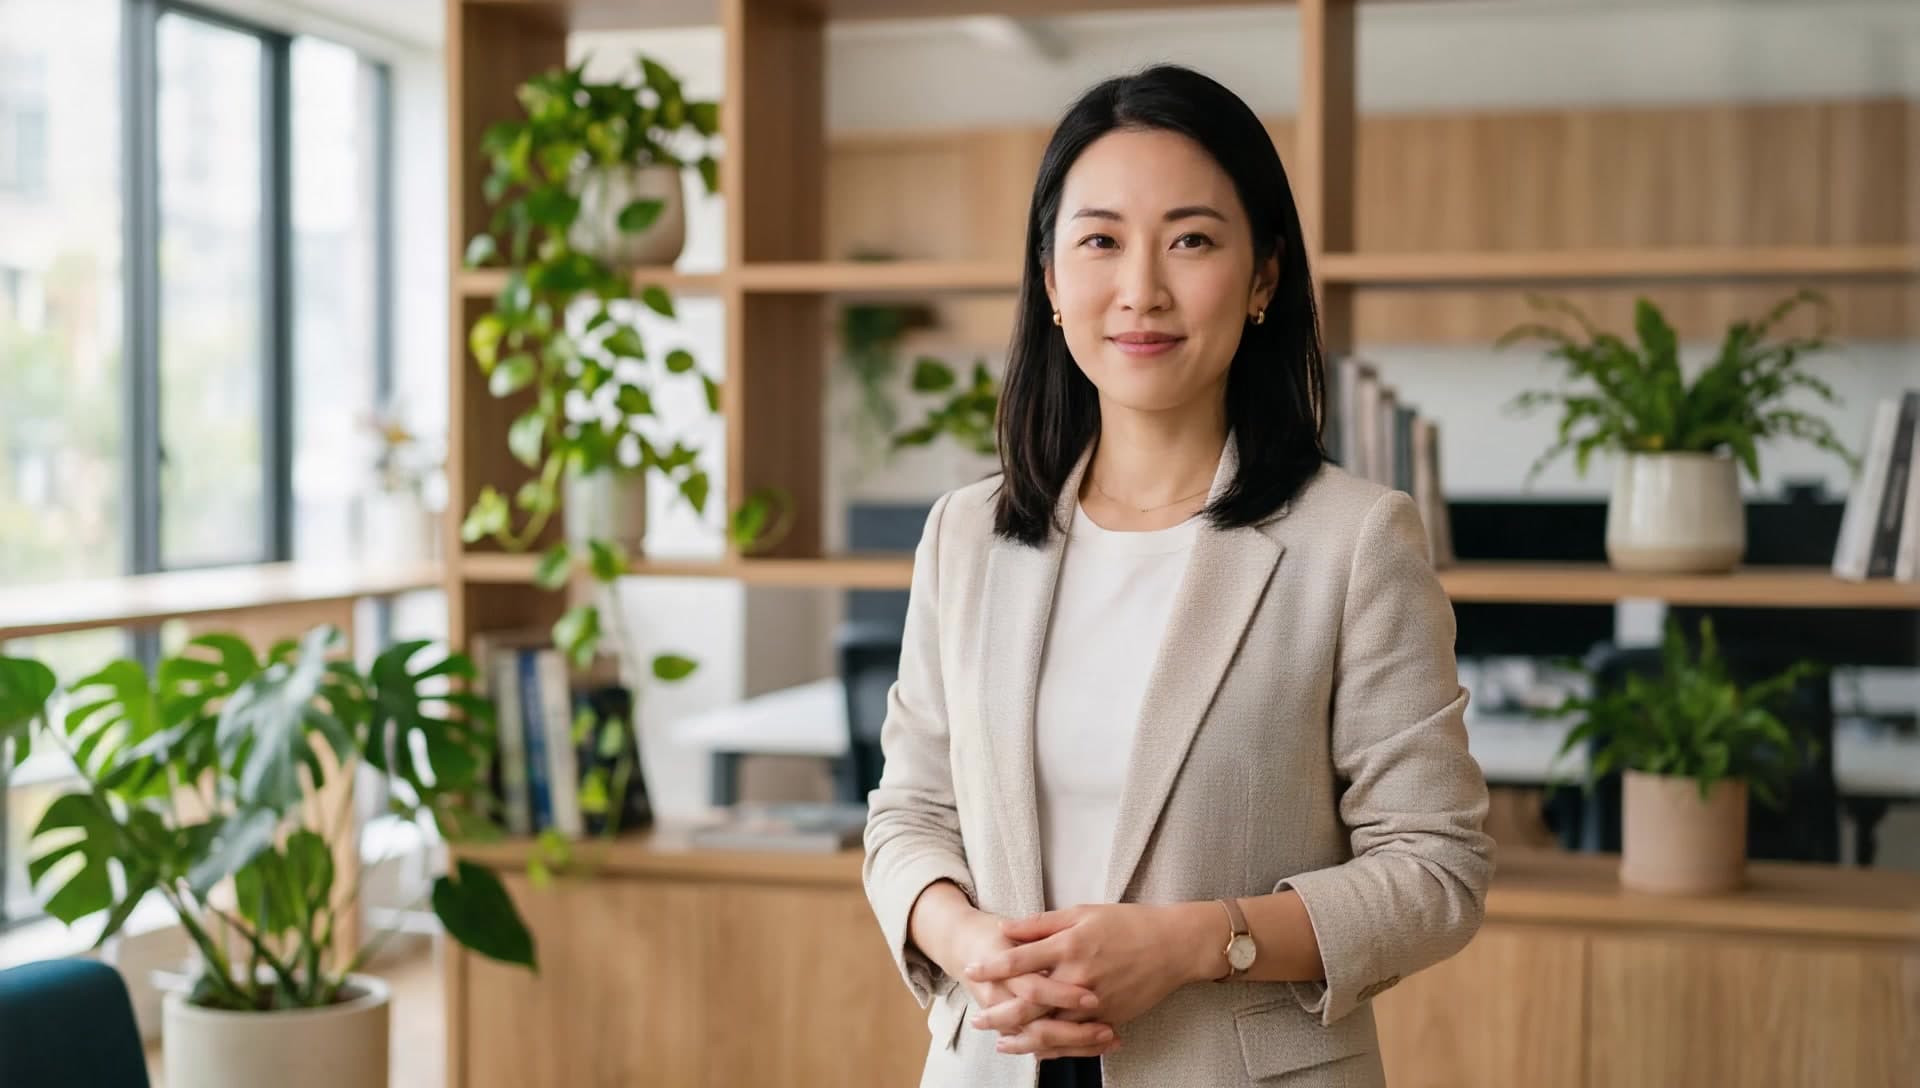
人像提供出镜人、服装和办公室背景,音频决定说什么和节奏,提示词让她在讲到功能时打开双手。输出保持 16:9 横版,口型跟随中文口播,点头、手势和肩部动作随语句起伏,背景和光线与原图一致。
8 秒1080p16:9
驱动音频
一段约 8 秒的中文新品发布口播,口型和节奏跟着录音走。
提示词:自然地微笑讲话,说到功能时双手轻轻打开做手势,偶尔点头
OmniHuman 1.5 API:上传一张人像和一段音频,生成口型同步、表情与肢体随语音变化的说话视频;支持真人、宠物和动漫角色、多语言配音、多人蒙版指定说话者,适合口播短视频、课程讲解和虚拟形象,可在线试用并查看实时价格。
提供商: ByteDance
类型: 视频生成
接口: /v1/tasks
状态: 已开放
消耗: 查看页面实时价格
OmniHuman 1.5 API:上传一张人像和一段音频,生成口型同步、表情与肢体随语音变化的说话视频;支持真人、宠物和动漫角色、多语言配音、多人蒙版指定说话者,适合口播短视频、课程讲解和虚拟形象,可在线试用并查看实时价格。
定价
标准用量
用图片控制视频的开始和结束画面。
准备生成
配置参数并点击"运行"查看输出结果。
看人像图里的人物如何按录音开口,口型、眨眼和肩部动作怎样跟随语音,以及画幅如何保持与原图一致。
音频驱动
人像提供出镜人、服装和办公室背景,音频决定说什么和节奏,提示词让她在讲到功能时打开双手。输出保持 16:9 横版,口型跟随中文口播,点头、手势和肩部动作随语句起伏,背景和光线与原图一致。
驱动音频
一段约 8 秒的中文新品发布口播,口型和节奏跟着录音走。
提示词:自然地微笑讲话,说到功能时双手轻轻打开做手势,偶尔点头
宠物与动漫
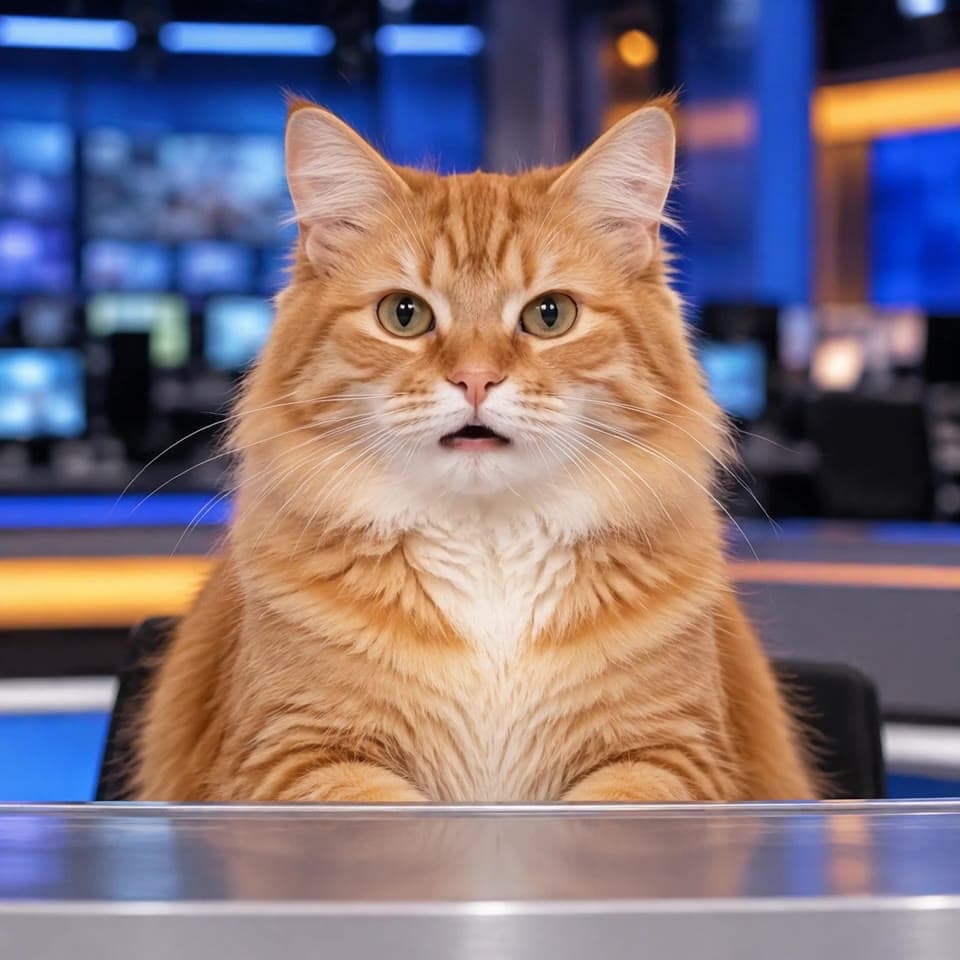
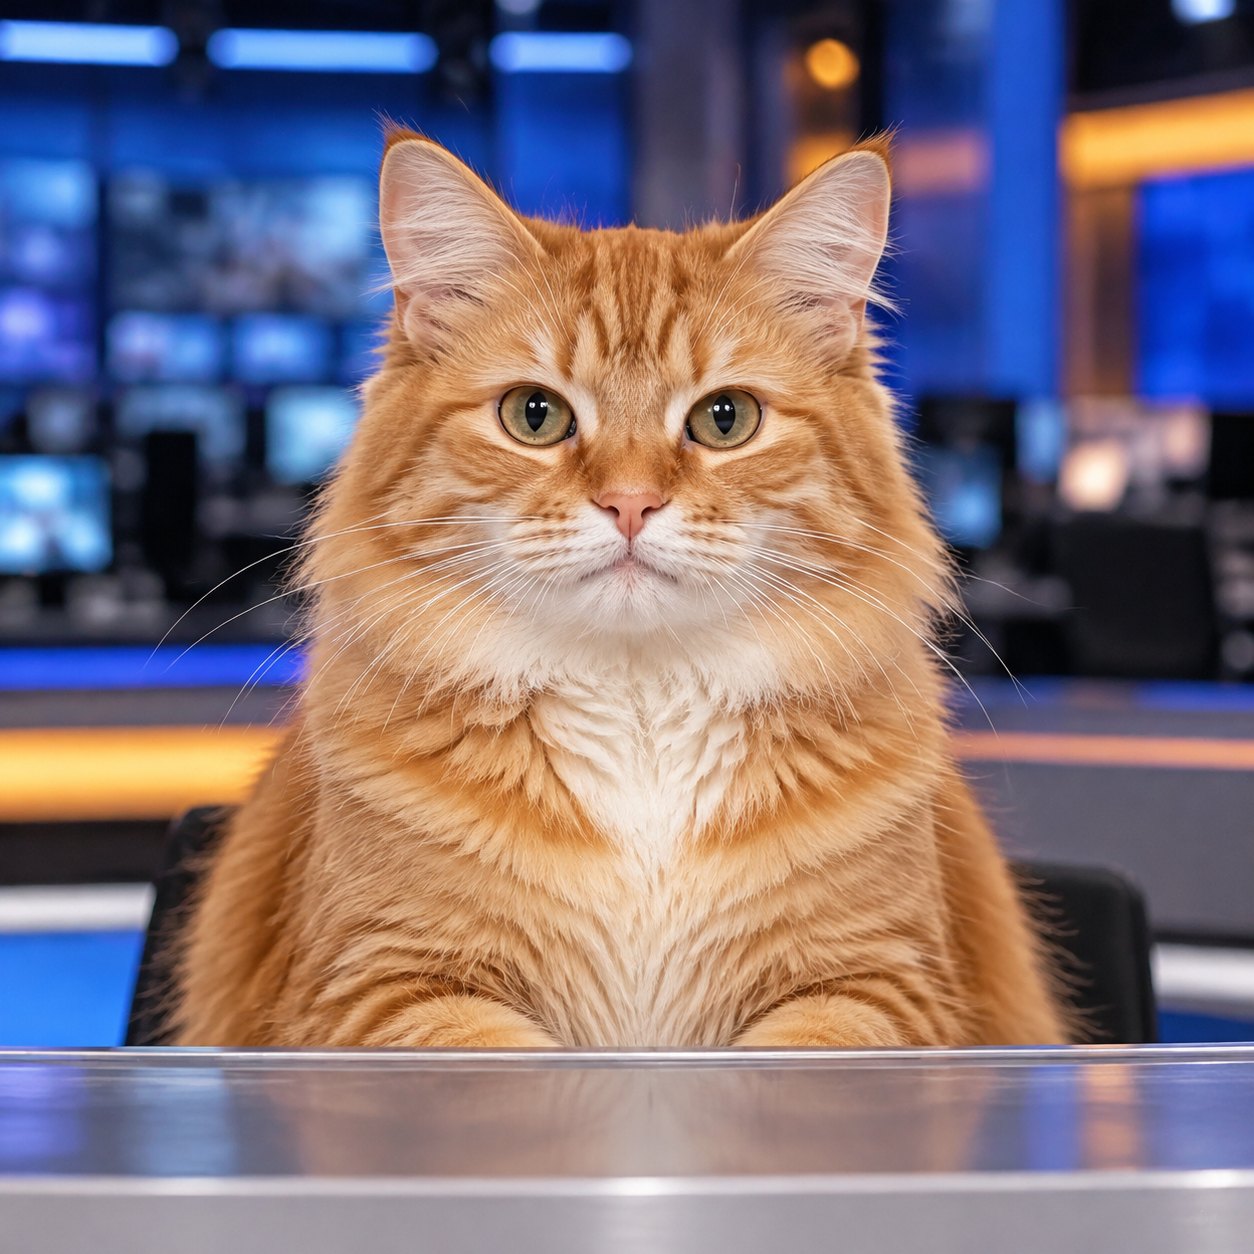
输入是一张方形猫图:橙色虎斑猫、新闻演播室背景、正脸清晰。8 秒中文音频让它开口,耳朵、胡须和眨眼跟着语句变化;输出保持 1:1,嘴部动作和头部微动都来自这段录音。
驱动音频
一段约 8 秒的中文新闻口播;输入人像是一张方形猫图。
提示词:对着镜头自然地播报新闻,说话时耳朵轻动,偶尔眨眼
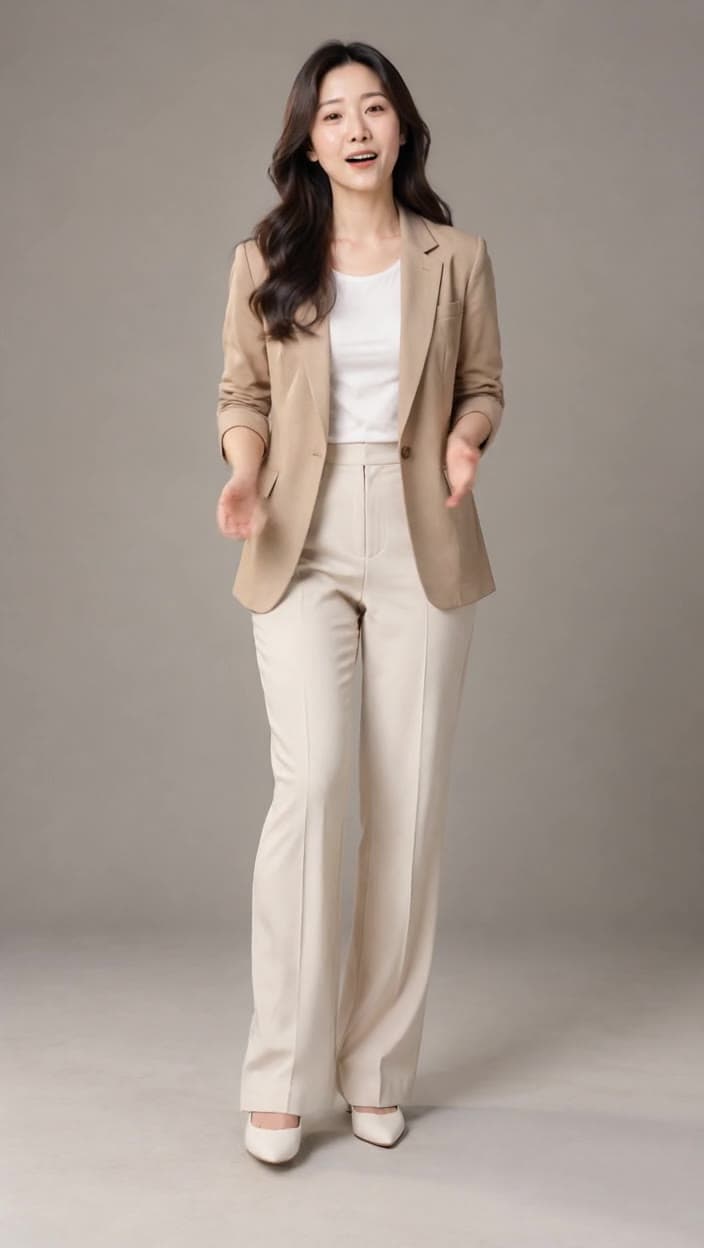
全身动作
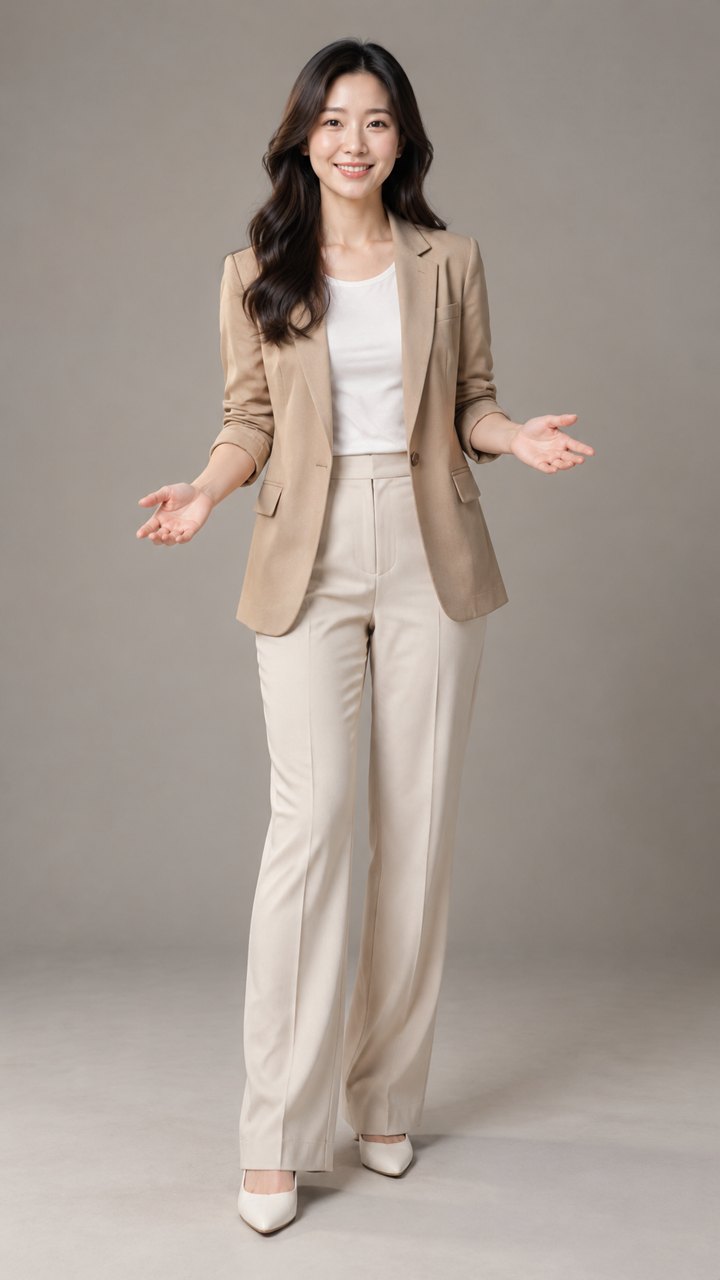
输入是竖版全身照,人物站在纯色背景前,双手已经微微打开。8 秒中文音频驱动口型,提示词让手势在讲到重点时展开;输出保持 9:16,肩部、手臂和重心随语句轻微变化。
驱动音频
8 秒中文讲解;全身人像,输出 9:16。
提示词:自然微笑讲话,双手随着讲解轻轻打开做手势,偶尔点头
多语言
沿用上面那张横版人像,只把驱动音频换成 7.5 秒英文介绍。口型按英文发音重新对齐,停顿和重音跟着英文录音走;背景、服装和画幅都不变。
驱动音频
7.5 秒英文产品介绍,与中文案例共用同一张人像。
提示词:Speak naturally to camera with a slight smile, open your hands when making a point, and nod occasionally.
多人蒙版
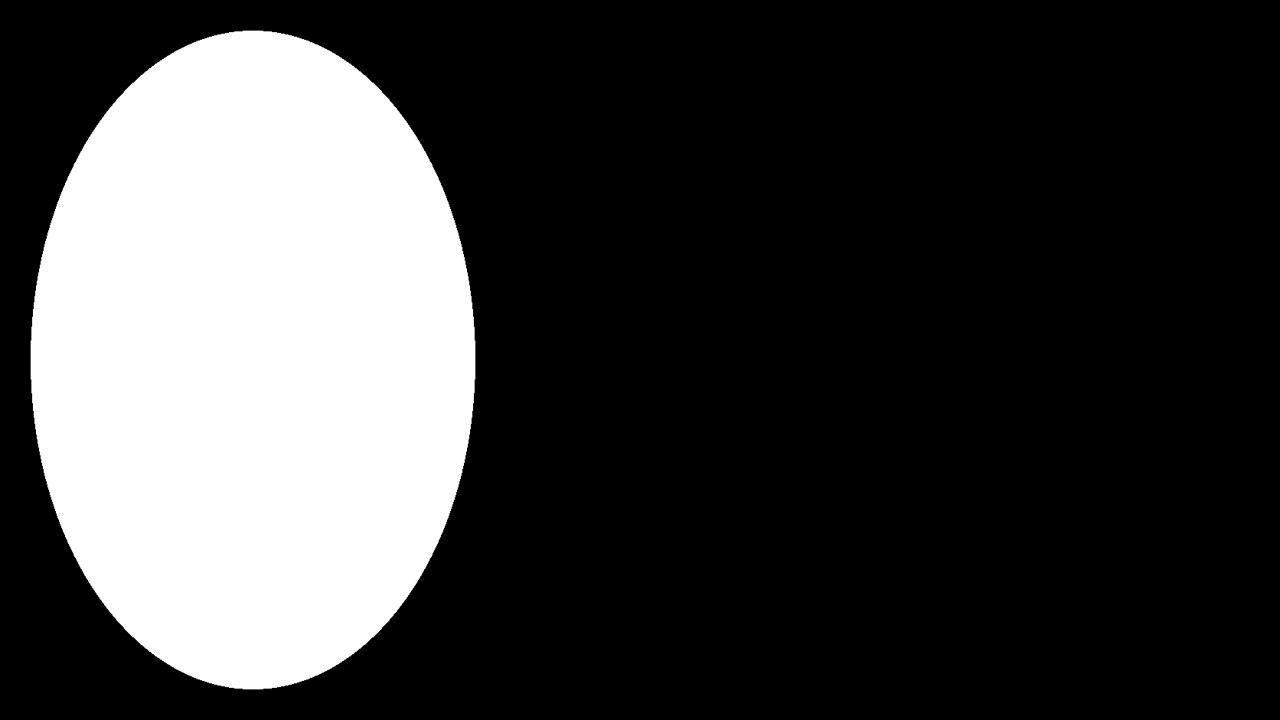
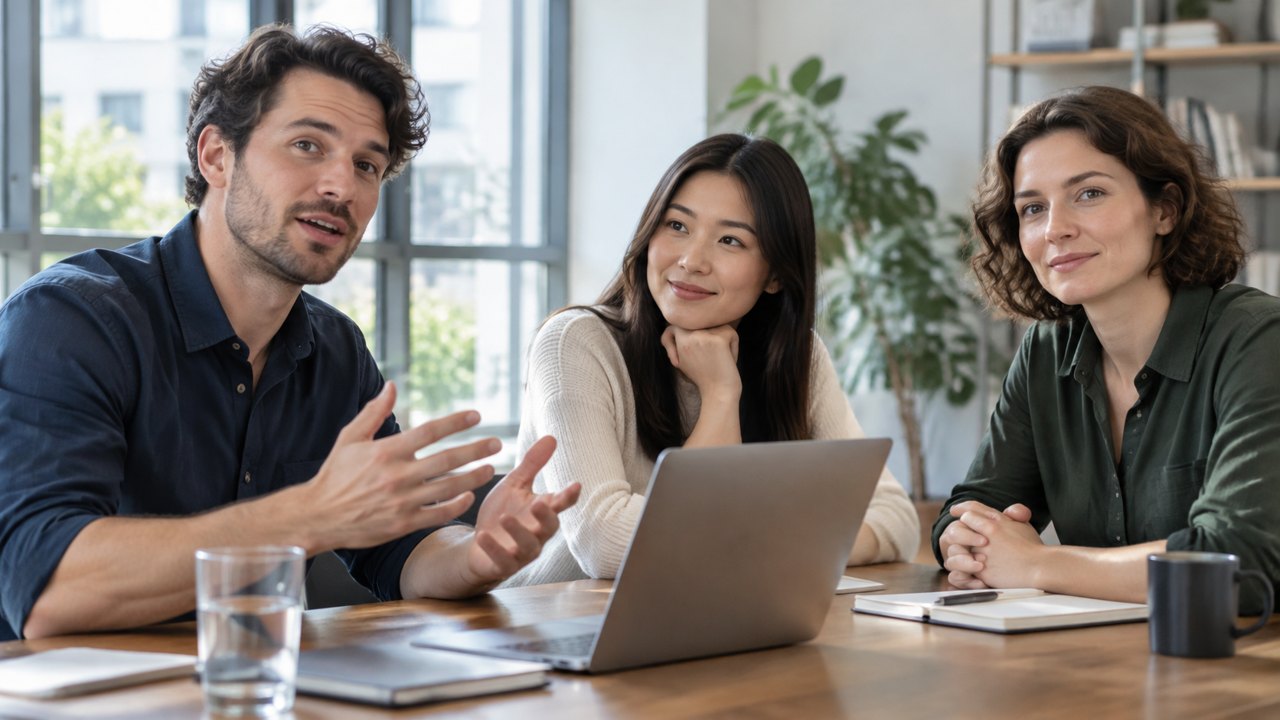
输入是一张 16:9 三人会议图,另附一张同尺寸蒙版:左侧男士区域为白,其余为黑。8 秒中文音频只驱动这位男士,中间和右侧的同事保持微笑聆听,头部和身体有自然的小幅动作。
驱动音频
8 秒中文会议发言;用蒙版指定左侧男士。
提示词:只有左侧的男士开口说话,中间和右侧的两位保持微笑聆听,身体轻微自然移动
说话者蒙版
需要台词配音的数字人、整段动作迁移或普通图生视频时,HiAPI 上还有这些模型可选。
提供商
输入人像
驱动音频
提示词
说话者蒙版
分辨率
输出
接口
价格
三步把一张人像变成说话视频:准备人像、准备音频、提交任务。先用 720p 和一段几秒的音频验证效果,再出正式版本。
选正脸清晰、嘴部无遮挡的单人图作为 image_url;真人、宠物或动漫角色都可以,视频画幅会跟随这张图。
把说话或唱歌的音频作为 audio_url,短于 60 秒、15 秒以内最佳。想控制表情或镜头时再加一句提示词;多人画面可用蒙版指定说话者。
通过 omnihuman-1.5 创建异步任务,用 callback.url 或 GET /v1/tasks/:id 获取结果,费用按实际输出秒数结算。
一个 POST /v1/tasks 请求即可提交数字人视频任务;完整参数、回调与错误处理见 API 文档。
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "omnihuman-1.5",
  "input": {
    "image_url": "https://example.com/portrait.jpg",
    "audio_url": "https://example.com/greeting.mp3",
    "resolution": "1080p"
  }
}'OMNIHUMAN 1.5 API
OmniHuman 1.5 是字节跳动的音频驱动数字人模型:上传一张人像图和一段说话或唱歌的音频,就能得到图中人物开口的视频。不需要录真人素材,也不需要先训练形象,人像图本身就是出镜人,音频决定说什么。
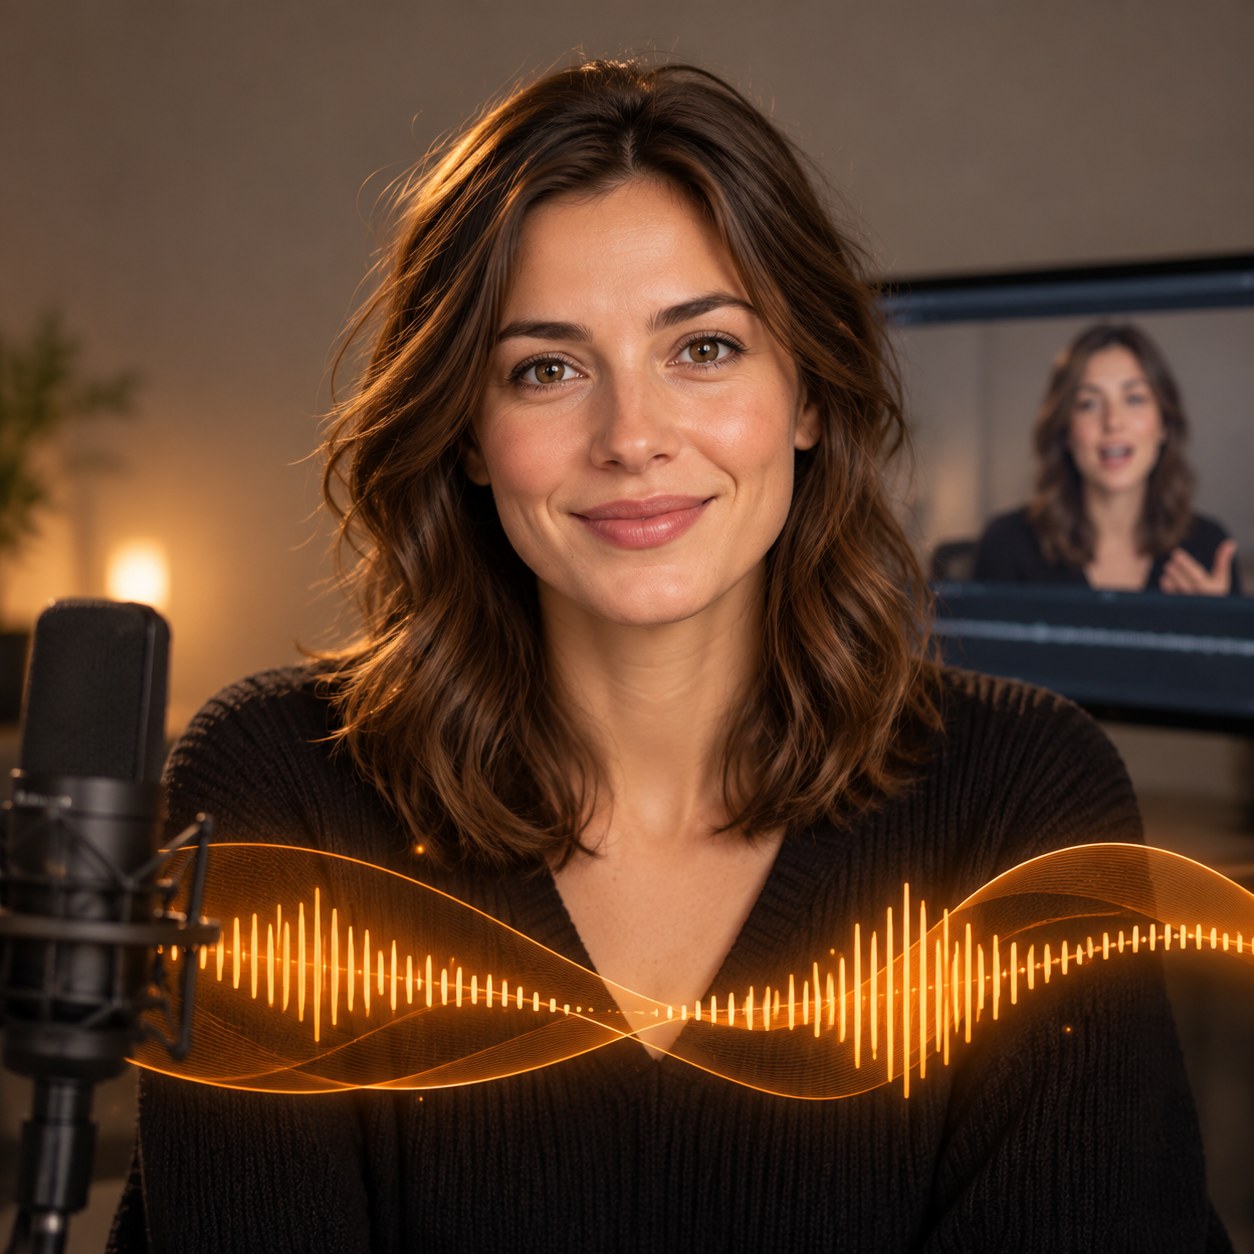
人像图决定人物长相、服装和场景,音频决定内容、语速和情绪起伏。模型负责口型同步,并根据语音节奏补上眨眼、点头、手势和肩部动作,让静态图片看起来像真的在对着镜头讲话;视频时长等于音频时长,画幅跟随人像图。
它适合已经有讲师、主播、品牌形象或虚拟角色图片,并且希望用自己的录音或配音来驱动的团队。换一段音频就能重新生成,不用重新拍摄。
从口播、宠物和动漫角色、唱歌、多语言,到让多人画面里指定的人开口,分别看 OmniHuman 1.5 的表现。
01
上传说话的音频,口型、停顿和情绪起伏都跟着它走,并补上眨眼、点头、手势和肩部动作;视频时长等于音频时长,不需要单独传时长。音频须短于 60 秒,15 秒以内效果最好,更长会降低画质。
想控制表情、手势或镜头时,可以再加一句不超过 300 字的提示词,例如“讲到功能时双手打开,偶尔点头”。新品发布口播这个案例就是这样:录音给内容和节奏,提示词只补充动作。
驱动音频也可以是唱歌。拖长的音节会让嘴型保持更久,节拍会带出点头和身体律动,适合虚拟偶像、品牌角色或一段短广告歌;歌曲同样受 60 秒上限约束,建议截取副歌或最有记忆点的片段。
02
模型直接驱动你上传的人像图,而不是换成自带的形象。发型、毛色、服装、背景和光线都会保留到视频里;画幅跟随原图,横版、竖版、方形都可以,不需要另外设置比例。
输入不限于真人照片:宠物、插画和动漫角色同样可以驱动。上面的猫主播案例用一张方形猫图配中文新闻口播,耳朵、胡须和眨眼都跟着语句变化;正脸清晰、嘴部无遮挡时效果最稳,半身或全身图会带出更多手势。
03
半身图能带出表情和肩部动作,全身图还能让手势、重心和站姿参与表达。上面的竖版全身案例里,人物原本双手微张,音频进来后,提示词让双手在讲到重点时进一步打开,身体随语句轻轻前倾。
全身案例适合课程讲解、发布会和竖版口播。人像的手部、脚部和背景要尽量完整,避免裁切;如果只想控制上半身,半身图的动作会更稳、画面也更紧凑。
04
口型同步不依赖语言,录音、配音或 TTS 都可以。上面两个案例使用同一张横版人像,中文和英文各一段音频,口型分别按两种发音重新对齐,背景、服装和画幅保持一致。
同一张人像配不同语言的配音,就能得到对应的本地化版本,不需要重新拍摄。提示词支持中、英、日、韩、西班牙语和印尼语,可以用与配音相同的语言写动作描述。
05
画面里有多个人物时,默认由模型自行判断说话者。想精确指定时,上传一张与人像图同尺寸的蒙版图(说话者区域为白、其余为黑),最多 5 张。上面的三人会议案例用蒙版锁定左侧男士,另外两位保持微笑聆听。
蒙版适合会议、访谈、群像和多人剧情;说话者切换时换一张蒙版再提交即可。快速模式会牺牲少量画质换取更短的生成时间,适合批量预览;固定随机种子并保持其他参数不变,可以得到高度一致的结果。
同一人像 · 两种语言
本地化视频不需要重新搭景或重拍人物。保持人像、服装、背景和画幅不变,只替换驱动音频,模型会按新语言重新对齐口型、停顿和重音;两版可以并排用于官网、社媒和广告投放。
同一套流程也适用于日语、韩语、西班牙语等配音。需要更多语言时,准备对应音频逐条提交即可,人像和提示词可以复用。
用主播或店员的照片配上录好的口播音频,批量生成竖版讲解和种草视频;全身图还能带出手势,换音频即可换内容。
讲师提供一张全身或半身照和每节课的音频,就能产出章节导读、知识点讲解等短视频,不用反复进棚录制。
插画、动漫或宠物形象配上配音,直接变成会说话的品牌角色;方形猫主播案例可以换成任何 IP 形象。
同一张人像配不同语言的配音,分别生成本地化视频,口型随每种语言的音频重新对齐,画风和构图保持不变。
多人画面用蒙版指定说话者,其他人物保持聆听和自然微动,适合会议纪要、访谈片段和多人剧情。
用一句提示词控制讲到重点时的手势、点头或镜头感,录音负责内容,画面保持同一套人物和场景。
提示词只负责动作和镜头,说什么由音频决定。下面三句分别对应新闻播报、产品发布和多人会议,可以按人物和场景改动词汇。
适合坐姿主播、方形或横版人像;强调语速平稳和轻微点头。
对着镜头自然地播报新闻,语速平稳,说到重点时微微点头,偶尔眨眼。
适合半身或全身出镜人;让手势在讲到功能时打开,避免全程大幅挥动。
自然微笑讲话,说到功能时双手轻轻打开做手势,偶尔点头,身体保持稳定。
配合蒙版使用;明确只让一个人开口,其他人保持聆听。
只有左侧的男士开口说话,中间和右侧的两位保持微笑聆听,身体轻微自然移动。
三个模型都能让人物开口或动起来,区别在于驱动信号从哪里来、能控制到什么程度。
OmniHuman 1.5
你已经有录音或配音,想让任意人像(含宠物、动漫角色)按这段音频开口,并带自然的表情和肢体动作。
HeyGen Avatar IV
你只有台词没有音频,想从预置声音里挑一个配音,或需要指定画幅与背景填充。
Kling 3.0 Motion Control
要把一段参考视频里的整段动作、手势和舞步迁移到照片人物身上,而不只是说话。
在 HiAPI 上,每条生成的视频、对应的参数和费用都会记在你的账户里,方便回看效果、复用参数和核对开支。
批量做本地化版本时,可以用 callback.url 接收结果,也可以用 GET /v1/tasks/:id 轮询;任务创建时按 20 秒预扣,完成后按实际输出秒数结算,金额和耗时都能在同一套日志里核对。
生成的视频可在产物记录中查看和下载,方便挑出效果最好的一版用于剪辑和投放。
创建时按 20 秒预扣,完成后按实际输出秒数多退少补;任务失败不产出视频,预扣费用按平台退款流程处理。
用 callback.url 或 GET /v1/tasks/:id 获取结果,适合一次生成多个语言版本或一组口播素材。
同一个 Key 也能调用图像、语音和其他视频模型,可以先生成人像和配音,再做数字人视频。
一张人像图(image_url)和一段音频(audio_url),两者都必填。提示词、蒙版、分辨率、快速模式和随机种子都是可选项。
正脸清晰、嘴部无遮挡的单人图最稳,真人照片、宠物、插画和动漫角色都可以;半身或全身图会带出更多手势。视频画幅跟随这张图,不需要另外设置比例。
说话或唱歌都可以,mp3、wav、aac、ogg、m4a 格式,最大 10MB;时长必须短于 60 秒,15 秒以内效果最好。视频时长等于音频时长。
模型单次只接受短于 60 秒的音频。较长的内容建议按段落切开,分别生成后再剪辑;同一张人像、同一套提示词可以复用,段落之间的口型和画面风格能保持连续。
可以。人像不限于真人照片,宠物、插画和动漫角色都能按音频开口;正脸清晰、嘴部无遮挡时最稳。上面的猫主播案例就是一张方形猫图配中文新闻口播。
可以。驱动音频既可以是说话也可以是唱歌,口型同步不依赖语言;同一张人像换不同语言的配音,就能分别生成对应语言的版本。上面的中文和英文案例共用同一张人像。
不是。不写提示词时,表情和动作由模型根据音频自行安排;想控制表情、手势或镜头时再写,最多 300 个字符,支持中、英、日、韩、西班牙语和印尼语。
上传与人像图同尺寸的蒙版图(说话者区域为白、其余为黑)到 mask_urls,最多 5 张,指定的人会对口型。上面的三人会议案例用蒙版锁定左侧男士,其他两位保持聆听。
输出 MP4,画幅跟随人像图,横版、竖版、方形都可以,不需要另外设置比例;分辨率可选 720p 或 1080p,视频时长等于音频时长。
支持。用 POST /v1/tasks 提交任务,通过 callback.url 接收结果,或用 GET /v1/tasks/:id 轮询;批量生成多个语言版本时,由应用管理并发和任务数量。
任务失败不会产出视频。预扣费用按平台退款流程处理,具体退款状态可在问题任务页查看。
OmniHuman 1.5 只接受音频驱动,但支持宠物和动漫角色、表情和肢体动作更丰富,并可用蒙版指定说话者;HeyGen Avatar IV 可以只给台词并从预置声音里选配音,还能指定画幅和背景填充。
按生成视频的实际秒数计费,720p 和 1080p 同价。创建任务时先按 20 秒预扣,完成后按实际输出秒数结算并退回或补扣差额;单价见本页实时价格。