拟音 · 金属撞击 · 1 秒
钢梁铁锤敲击
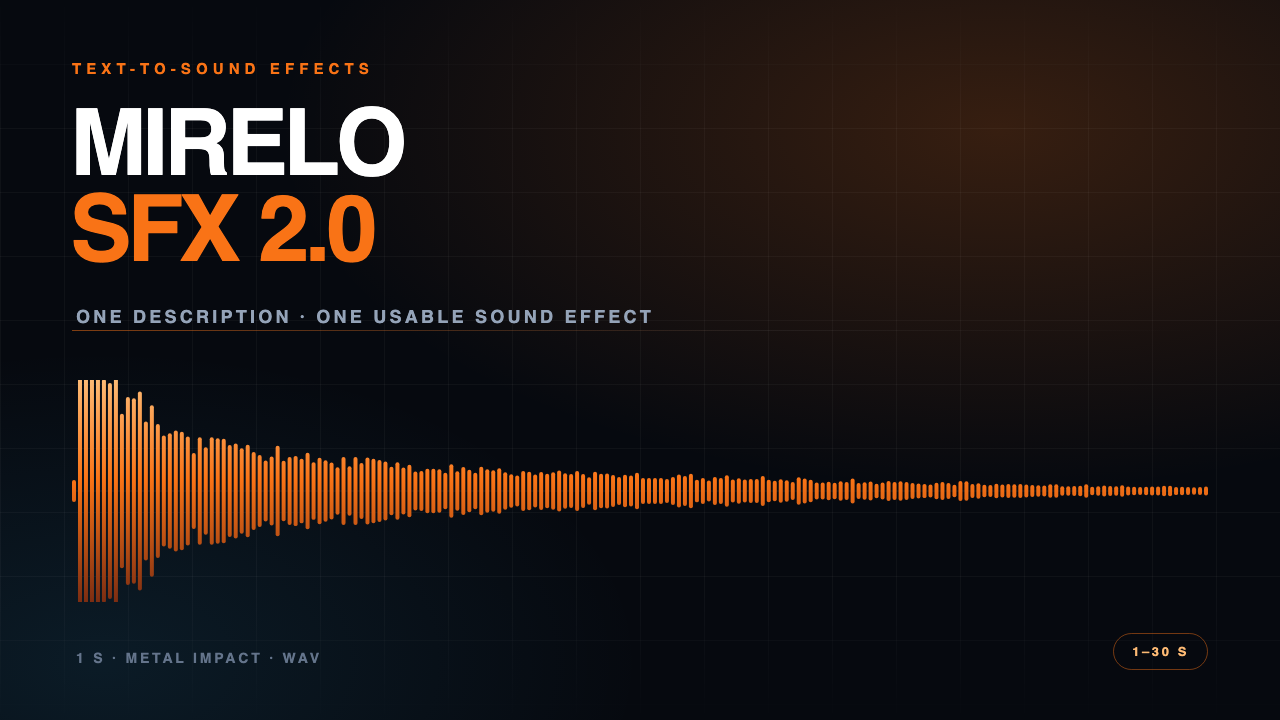
1 秒近距离铁锤敲击钢梁,尖锐起音与长金属余响。
0:00--:--
实测 1.00 秒 · WAV · PCM 16-bit / 48 kHz / 单声道
声音描述
A single heavy hammer strike on a steel beam in a large empty warehouse, sharp transient, long metallic ring, close perspective.
- duration
- 1
Mirelo SFX 2.0 是文生音效模型,用文字描述声音来源、材质、动作与环境,生成 1–30 秒 WAV 音效,适合视频拟音、游戏音效和短视频。在 HiAPI Playground 在线试用,查看价格、参数与异步 API 接入示例。
提供商: Mirelo AI
类型: 音效生成
接口: /v1/tasks
状态: 已开放
消耗: 查看页面实时价格
生成音效的秒数,1–30 的整数,默认 5 秒。时长越长,费用越高,范围:1 - 30,必须是整数
准备生成
配置参数并点击"运行"查看输出结果。
案例保留可播放音效、完整声音描述和本次请求的真实时长参数,方便判断冲击力、空间感与尾音。
1 秒近距离铁锤敲击钢梁,尖锐起音与长金属余响。
实测 1.00 秒 · WAV · PCM 16-bit / 48 kHz / 单声道
声音描述
A single heavy hammer strike on a steel beam in a large empty warehouse, sharp transient, long metallic ring, close perspective.
10 秒雨夜环境声:密集雨滴打在波纹金属屋顶,远处闷雷,排水沟持续流水。
实测 10.00 秒 · WAV · PCM 16-bit / 48 kHz / 单声道
声音描述
Heavy rain at night on a corrugated metal roof, dense overlapping droplets, distant rolling thunder, water running into a gutter, close-to-mid perspective, steady ambience with no music and no voices.
2 秒座舱界面确认音:全息轻触、明亮双音数字提示、短促低频脉冲。
实测 2.00 秒 · WAV · PCM 16-bit / 48 kHz / 单声道
声音描述
A short sci-fi interface confirmation in a quiet cockpit: a soft holographic tap, a bright two-tone digital chime, and a quick sub-bass pulse, clean and close, with a very short room tail.
3 秒大型生物低沉咆哮:喉部粗糙质感、胸口低频厚度、远处岩壁回声。
实测 3.00 秒 · WAV · PCM 16-bit / 48 kHz / 单声道
声音描述
A deep guttural roar from a large creature in a stone canyon, raspy throat texture, sharp attack, chest-heavy low end, distant rocky echo, mid perspective.
根据音乐、单人语音或多人对白任务选择相邻路线。
MIRELO SFX 2.0
Mirelo SFX 2.0 是文生音效模型:输入只有文字描述和时长,输出 1–30 秒的 WAV 音效。它适合视频拟音、游戏音效、短视频和播客声音设计;不生成歌曲、人声或对白。
按输出秒数计费,1 秒起生成;实时单价见页面顶部价格卡。
MODEL OVERVIEW
Mirelo SFX 2.0 是 Mirelo AI 的文生音效模型。它把一段声音描述变成单条音效:铁锤敲击钢梁、雨打金属屋顶、科幻界面确认、峡谷生物咆哮,都可以用一句话描述声源、材质、动作、距离和环境来生成。每次请求输出一条 WAV 音频,时长 1–30 秒,默认 5 秒。
本页接入的是文生音效接口:输入只有文字描述和时长,不需要上传视频,也不做自动视频拟音。它不生成歌曲、人声或对白;需要完整音乐时选音乐模型,需要单人语音或多人对白时选语音模型。把能力边界说清楚,能避免在错误的场景里反复试错。
音效的质量很大程度取决于描述是否具体。写清“什么物体、什么材质、如何接触、多远、在什么空间里、起音和尾音是什么样”,比堆叠“震撼、真实、电影感”更有效。页面上的 4 条案例分别覆盖金属拟音、雨夜环境声、游戏 UI 和生物咆哮,可以直接试听、查看完整 prompt,并复制真实输入。
页面上的 4 条案例都来自真实请求,而不是宣传样音:每条都记录了完整 prompt、duration、实测时长和 WAV 格式,音频文件直接放在页面里播放。你可以先用它们判断模型是否适合当前项目,再把自己的声音描述换成同样的结构,逐步调整材质、距离和尾音。
如果你第一次接触文生音效,建议从 1 秒的金属拟音开始:它最容易听出材质和瞬态是否正确。确认后再试 10 秒环境声,观察模型在长时间里是否保持层次;最后再尝试 UI 和生物咆哮这类需要情绪与空间的声音。按这个顺序试听,比一上来就写复杂场景更容易建立对模型的判断。
KEY FEATURES
每条能力都对应本页的真实案例、公开参数或请求结构。波形图来自页面上的实际生成音频,不是示意图。
01
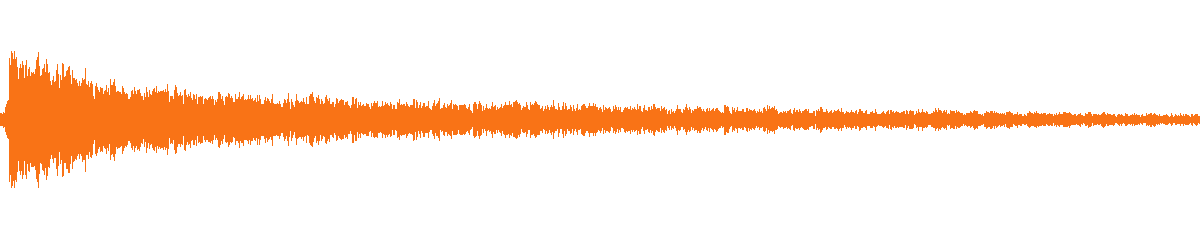
把声源、材质、动作、距离与空间、环境、起音与尾音写进同一条描述,Mirelo SFX 2.0 会输出一条完整音效,而不是一段需要再拼接的采样。页面第一条案例只用了 1 秒:铁锤敲击钢梁、空旷仓库、近距离、尖锐起音与长金属余响,生成结果保留了清晰的瞬态和金属尾音。
对剪辑和游戏音频来说,这意味着可以先按画面写声音,再直接拿到可用文件,减少在素材库里反复试听的时间。一条描述只讲一个事件通常更稳定;如果要同时表现撞击、破碎和碎片落地,分成几条请求会比塞进一句话更容易控制。
02
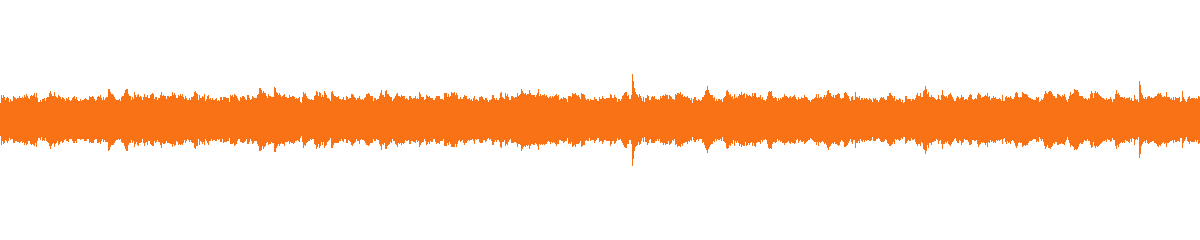
duration 接受 1–30 的整数秒,默认 5 秒。单次动作、UI 反馈和转场适合 1–3 秒;雨声、机器运转和空间底噪可以用 10–30 秒覆盖完整镜头。页面里的雨夜案例把 duration 设为 10 秒,生成结果正好覆盖一段连续环境声,不需要在剪辑里循环拼接。
整数秒的好处是可预测:你写 10,输出就是 10 秒,批次规划和时间线对齐都更直接。先按镜头长度确定秒数,再写声音描述,通常比先生成再裁剪更省时间;如果镜头长度还没定,先用 1–3 秒验证音色,确认后再生成正式版本。
03
公开契约把 prompt 的上限设为 2,000 字符,最短 1 个非空字符。这个长度足够写清声源、材质、动作、距离、空间、环境、起音和尾音,也可以补充“不要音乐、不要人声”这类边界。对需要把声音规范写进模板的团队,长提示词比短关键词更容易复用和审阅。
它不提供 prompt_influence 滑杆,控制感来自描述本身:把想要的细节写具体,把不想要的元素排除掉。右侧是一条完整的请求示例,prompt 和 duration 就是全部公开输入;复制后可以直接提交,不需要再补隐藏参数。
{
  "model": "mirelo-sfx-2.0",
  "input": {
    "prompt": "An old wooden door creaks open slowly in a quiet room, low hinge friction, a soft latch click, close perspective.",
    "duration": 6
  }
}
04
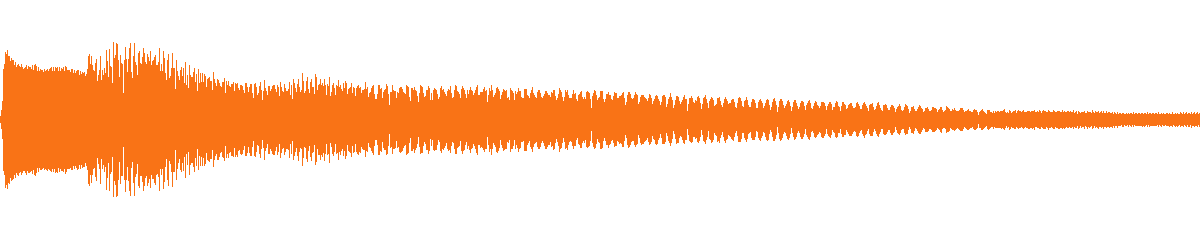
每次请求返回一条 WAV 音频。实测文件为 PCM 16-bit、48 kHz、单声道,常见剪辑软件、游戏引擎和音频工具都能直接读取,不需要先转码。首版不提供 MP3、Opus 等其他格式,也不支持一次请求返回多条样本;需要多个版本时,分别提交请求或改变一个描述变量后重新生成。
格式单一换来的是流程简单:拿到文件就能进时间线或引擎,不用先判断采样率、位深和声道是否兼容。如果下游必须使用压缩格式,可以在自己的流水线里统一转码;生成端保持无损 WAV,后续再处理不会多一次有损环节。
05
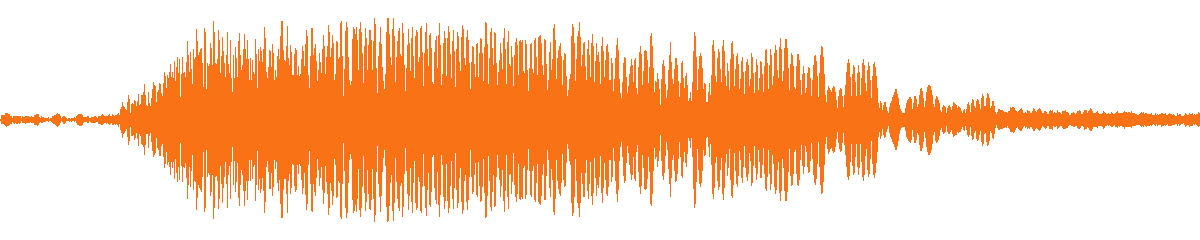
音效迭代最怕一次生成很长却方向不对。建议先用 1–3 秒验证材质、瞬态和空间感,确认后再把 duration 拉到镜头需要的长度。页面里的生物咆哮案例用 3 秒完成一次短试听:喉部质感、低频厚度和峡谷回声都能在 3 秒内判断。
短试听同样走真实请求,生成结果可以直接保留,也可以作为长版本的参考。把“试听版”和“正式版”分开管理,能让团队在确认方向之前不浪费长音频的生成时间;确认后再生成 10–30 秒版本,整体迭代次数通常更少。
06
同一动作换一种材质,声音的起音和尾音会完全不同:钢梁有长金属余响,木门是低频摩擦和短促扣合,石壁则带回声。距离和空间同样重要,近距离强调瞬态,空旷仓库和峡谷会把尾音拉长。把“什么物体、什么材质、多远、在什么空间里”写清楚,比堆叠“震撼、真实、电影感”之类的形容词更有效。
这也是拟音工作的自然写法:先决定画面里的物体和接触方式,再决定摄影机离它多远,最后补环境。把这套顺序固定成模板后,同一条音效在不同项目里只需要替换材质和空间关键词,描述结构本身可以一直复用。
CASE NOTES
四条案例都按“声源 → 材质 → 动作 → 距离与空间 → 环境 → 起音与尾音”组织,但每条只保留与任务相关的信息。下面的拆解不复述 prompt 原文,而是说明该听什么、下一次该改什么。
1 秒案例的重点不是“锤子”,而是材质和空间。描述里同时给了钢梁、空旷仓库、近距离、尖锐起音和长金属余响,模型才有足够信息决定瞬态多硬、尾音多长。只写“敲击声”时,结果可能更像木头或塑料;把金属、空间和尾音补齐,声音才会落在同一个材质世界里。试听时先听起音是否够快,再听余响有没有金属感,最后才判断整体音量。
试听这条案例10 秒环境声最容易被写成“下雨”。这条案例补了波纹金属屋顶、密集雨滴、远处闷雷、排水沟流水和近中景,还明确排除了音乐和人声。环境声的难点不是单个事件,而是持续层次:雨滴要有密度变化,雷声要远,流水要连续。试听时关注 10 秒内是否有明显重复或突然断层;如果有,下一次可以缩短时长、减少同时出现的元素,或把空间写得更大。
试听这条案例2 秒 UI 音效的可用性取决于起音和尾音,而不是信息量。这条案例用了全息轻触、双音数字提示、短促低频脉冲、安静座舱和很短的房间尾音,把“确认”拆成三个连续动作。UI 音效通常要短、干净、可重复,太长会打断操作节奏;如果听起来拖沓,先把尾音缩短,再减少低频脉冲的长度。
试听这条案例3 秒生物咆哮要同时表达体型、情绪和空间。这条案例写了低沉咆哮、喉部粗糙、尖锐起音、胸口低频、远处岩壁回声和中景,让声音既有近距离的力度,又有峡谷的距离感。试听时先判断低频是否足够厚,再听喉部是否有纹理,最后听回声是否把声音推远;如果回声太近,下一次把空间写得更开阔,或把“远处”换成具体的岩壁距离。
试听这条案例MODEL COMPARISON
下面只比较公开文档里的能力边界:时长、输出格式、提示词长度和控制参数。不比较价格或主观效果排名,也不把某一家的宣传当成通用结论。
01
两个模型都把上限放在 30 秒,但控制方式不同。Mirelo SFX 2.0 只接受 1–30 的整数秒,默认 5 秒,时长直接对应输出音频的秒数;ElevenLabs Sound Effects 的 duration_seconds 接受 0.5–30 秒的小数,省略时由服务估算时长。
需要严格对齐剪辑时间线、按整秒规划批次时,整数秒更直接;需要 0.5 秒级的极短 UI 点缀时,ElevenLabs 的小数时长更灵活。两者都适合短片和游戏音效,选择取决于你要的是可预测的整秒,还是更细的时长刻度。
02
Mirelo SFX 2.0 每次请求只返回一条 WAV,实测为 PCM 16-bit、48 kHz、单声道,适合直接进入剪辑软件和游戏引擎。ElevenLabs Sound Effects 默认返回 MP3,也提供 48 kHz WAV(用于非循环音效),API 还可选择 PCM、μ-law、A-law 和 Opus 等多种输出格式。
需要最少后处理、统一交付 WAV 时,Mirelo 的单一格式更省事;需要在 MP3、PCM、Opus 之间按带宽、引擎或存储要求切换时,ElevenLabs 的格式选择更多。一些通用音效接口默认返回压缩格式,再按需提供无损或高采样率版本;如果你的流水线已经统一转码,这一项差异会被抵消。
03
Mirelo SFX 2.0 的公开契约只暴露 prompt 和 duration,prompt 最长 2,000 字符,所有控制都写在描述里。ElevenLabs Sound Effects 同样以文本为主,但额外提供 0–1 的 prompt_influence(默认 0.3)和循环选项,其公开 API 参考没有列出文本字符上限,使用前应以当前文档为准。
一些通用音效接口还会提供 loop、seed、negative_prompt 等控制项。Mirelo 把参数面收窄到两个字段,换来的是请求结构简单、描述即规范;ElevenLabs 和这些接口则把一部分控制从文本里拿出来,交给滑杆和独立字段。需要把声音规范写成可审阅的长模板时,Mirelo 的字符预算更明确;需要快速微调文本影响力或做无缝循环时,参数更多的接口更直接。
以上对比只依据双方公开文档中的能力边界,不涉及价格或主观效果排名。模型能力会更新,接入前请以当前文档和页面参数为准。如果某个能力对你的项目是硬性要求,先写一个最小请求验证,再决定是否接入,而不是只看对比表。如果表里的差异不影响你的输入方式,选请求结构更简单的那一个即可。
PROMPT GUIDE
下面的顺序不是硬性语法,而是一套检查清单。写完后逐项对照,通常能发现描述里缺的是材质、距离还是尾音。
先写声源和材质:什么物体、什么材料、如何接触。材质决定瞬态和余响,钢、木、石、玻璃的差别远大于形容词。
再写动作和接触方式:敲击、刮擦、坠落、推开、关闭。一个动词只对应一个事件,避免一条提示词里堆三四个动作。
写清距离与空间:近景、远景、室内、空旷仓库、金属管道或石质峡谷。空间感会明显改变混响和低频。
补上起音和尾音:尖锐、沉闷、短促、长金属余响、逐渐衰减。具体的声音形状比“震撼”“真实”更有用。
需要排除的元素直接写出来:不要音乐、不要人声、不要观众掌声。边界越明确,结果越接近单条音效。
一次只改一个变量,并用 1–3 秒试听;确认后再生成 10–30 秒的完整版本。不同请求之间不保证逐样本一致。
QUALITY CHECK
不需要每次都写满 2,000 字符,但下面 5 个问题至少要能回答。任何一个答不上来,生成结果通常就会在那一个维度上变得模糊。它们不是评分表,而是排查顺序:先确认声源和材质,再看动作、空间、包络和排除项;每次只改一个答案,才能判断是哪一项影响了结果。如果只能回答其中三项,优先保留声源、材质和空间,这三项对音色和距离的影响最大。每次生成后把有效的描述保存下来,下一次只替换项目关键词。
“撞击声”不是声源,“铁锤敲击钢梁”才是。材质决定瞬态和余响:钢、木、石、玻璃、布料在同一动作下会给出完全不同的起音和尾音。如果结果听起来像另一种材料,先改材质词,不要急着加形容词。
一条提示词里同时写撞击、破碎、碎片落地和火焰燃烧,模型很难判断主次。把最重要的那个事件放在前面,其他层次拆成单独请求;如果必须在一个文件里完成,明确写出时间顺序,例如先撞击、再碎裂、最后碎片落地。
近距离强调瞬态,远景会削弱高频并增加混响;室内、空旷仓库、金属管道和石质峡谷各有不同的反射。写“近距离、空旷仓库”比只写“有回声”更可控,因为前者同时给了距离和空间类型。
起音是声音多快到达峰值,尾音是峰值之后如何衰减。写“尖锐起音、短促衰减”或“柔和起音、长金属余响”,比“听起来真实”更能指导生成。试听时先只听前 200 毫秒,再听最后一段,通常就能判断包络是否符合预期。
音效生成容易带入音乐、人声、掌声或额外的环境层。把“不要音乐、不要人声、不要观众”写进 prompt,比生成后再用音频工具清理更省事。排除项不需要很长,但要具体;如果结果仍然带入不需要的元素,减少描述里的情绪和场景词,通常能收敛。
HOW TO USE
从试听到接入分 4 步。前两步在页面上完成,后两步把验证过的参数搬进代码;每一步都有明确的产出,不需要先读完整套 API 文档。
在页面顶部的 Playground 里填写声音描述,把 duration 设为 1–3 秒,先确认材质、瞬态和空间感。短试听能快速暴露描述里缺失的要素,比如没有写距离导致声音太近,或没有写空间导致尾音太干。确认方向后,再把 duration 调到镜头需要的长度。页面上的 4 条案例都可以直接试听,作为描述写法的参考。
在 HiAPI 控制台创建 API Key,请求时使用模型 ID mirelo-sfx-2.0。音效、音乐和语音模型共用同一个任务入口,API Key 也由平台统一管理;你不需要为这个模型单独维护一套鉴权。第一次接入建议先用 Playground 里验证过的 prompt,避免同时调试描述和代码。
向 POST /v1/tasks 提交异步任务,body 里放 model 和 input,input 至少包含 prompt,按需包含 duration。prompt 写声源、材质、动作、距离与空间、环境、起音与尾音;duration 写 1–30 的整数秒。下面的快速示例就是本页第一条案例的真实请求,可以直接复制运行。
创建任务后会立即返回 taskId,音频在后台生成。你可以用 GET /v1/tasks/:id 轮询状态,也可以在请求里提供 callback.url 接收完成通知;成功后从结果里读取音频地址。生产环境建议保存 taskId、prompt 和 duration,便于追踪每次生成;失败任务会退回扣费,不需要自动重复提交。
APPLICATIONS
场景按“谁在用、输入什么、拿到的资产放在哪里”来写。每条都对应前面案例里的能力,不需要额外假设。如果你的场景不在列表里,先用一条 1 秒案例验证输入输出是否匹配,再决定是否扩展成长版本。
剪辑里常见的缺口是撞击、开关、脚步、衣物摩擦和环境底噪。按镜头长度生成 1–5 秒的音效,直接对齐剪辑点;需要铺满一段场景时,用 10–30 秒的环境声覆盖。适合独立剪辑师、广告后期和短视频团队,在没有现场拟音素材时快速补齐声音层。
按钮、拾取、技能触发、门和机关都需要短促、可重复的反馈音。用 1–2 秒的 duration 生成 UI 音效,用 3–10 秒生成环境底噪或机关循环,再按引擎要求导入 WAV。适合独立游戏、原型和互动装置团队,在音频预算有限时先建立完整的声音反馈。
画面里的空间感很大一部分来自声音:雨夜、街道、室内房间、金属仓库都有不同的底噪和混响。用一条 10–30 秒的环境声铺底,再叠加 1–3 秒的动作音效,可以在不增加拍摄投入的情况下让画面更完整。适合品牌短片、产品广告和社媒内容。
播客和有声书需要转场、强调、翻页、开关等短音效,但一次性声音往往不值得长期订阅素材库。用一句描述生成 1–3 秒的音效,按节目风格统一材质和空间,再批量复用到不同段落。适合播客制作人、有声内容团队和课程制作方。
在正式拟音、采购素材或录制之前,先用生成的版本验证节奏、时长和情绪是否成立。原型阶段可以用 1–5 秒快速迭代,确认后再决定是否投入录音棚或购买版权素材。适合动画 previz、游戏灰盒和广告提案。
把常用的声音规范写成模板:声源、材质、动作、距离、空间、起音、尾音各一段,再按项目替换关键词。这样每次生成都沿用同一套描述结构,团队之间也更容易审阅和复用。适合需要持续产出大量音效的内容平台、游戏工作室和自动化工具。
RELATED AUDIO MODELS
Mirelo SFX 2.0 只解决“一条音效或环境声”。如果你要的是完整歌曲、配乐、旁白或多人对白,直接换相邻模型会比在本页反复试更有效。
只需要一条音效或环境声,按时长可控地生成,输出 WAV。
需要完整歌曲、器乐或配乐,而不是单条音效。
需要最长 10 分钟的音乐、分段创作计划或参考音频引导。
需要多人对白或角色语音,而不是音效。
WHY HIAPI
下面 6 点讲的是接入和协作方式,不是模型效果排名。它们决定了从试听到上线要花多少工程时间。这些差异不会改变模型本身的能力,但会直接影响第一次请求到正式上线之间的距离。
HiAPI 把音效、音乐、语音合成和多人对白放在同一个平台上。你用一个 API Key 就能调用不同音频能力,不需要为每个模型单独申请账号或维护多套鉴权。对正在搭建音频功能的产品来说,先把入口统一,后续换模型或加能力都更容易。
音效、音乐和语音模型都通过 POST /v1/tasks 提交,返回 taskId 后轮询或回调获取结果。提交、轮询、错误处理和产物读取的结构一致,换模型时主要改 model 和 input,不需要重写任务框架。
页面上的 Playground 和 API Quickstart 使用同一个模型 ID 和 input 结构。你可以先在 Playground 里试听、调整 prompt 和 duration,再把验证过的参数复制到代码里,减少“页面能用、接口不通”的落差。
音效按时长计费,Playground 会根据 duration 显示预估,方便在生成前控制批次规模。最终扣费以成功任务为准,失败任务会退回;价格入口始终指向实时价格,不在正文里写死数字。
平台统一处理任务状态、轮询、回调和产物地址,你不需要直接对接模型服务的任务协议。对生产系统来说,少一层自建任务队列和状态机,接入和维护工作都更少。
模型的参数、示例、错误说明和中英文文档来自同一份公开契约。团队里中文和英文使用者看到的是同一组字段、同一组限制,减少因为文档不同步导致的请求错误。
SPECIFICATIONS
以下规格对应当前公开请求契约;价格以页面实时价格为准。
API QUICKSTART
复制最小请求,替换 prompt 和 duration 即可。完整参数、任务查询和错误码见 API 文档。
POST /v1/tasksmirelo-sfx-2.0创建请求会立即返回 taskId;音频生成在后台异步完成。
创建任务会立即返回 taskId,音频在后台生成。轮询 GET /v1/tasks/:id 或在请求里提供 callback.url;成功后读取音频地址。生产环境建议记录 taskId、prompt 和 duration,便于复现和排查。
参数校验失败会在提交阶段返回错误;任务失败会退回扣费。不要对失败任务自动重复提交,先检查 prompt 是否为空、duration 是否在 1–30 之间,再决定是否重新生成。
在 Playground 里写清声源、材质、动作、距离与环境,先用 1–3 秒试听;确认后再把 duration 调到镜头需要的长度。如果你想先从现成写法开始,回到上面的 4 条案例,复制完整 prompt 后只改一个变量;确认方向后,再把时长扩展到正式版本。
Mirelo SFX 2.0 是 Mirelo AI 的文生音效模型:用一段文字描述声音的来源、材质、动作、距离与环境,生成 1–30 秒的 WAV 音效。它适合视频拟音、游戏音效、短视频和播客的声音设计,不用于生成歌曲或人声对白。
本页接入的是文生音效接口,输入只有文字描述和时长,不需要上传视频,也不会自动分析画面。视频自动拟音属于另一条产品能力;如果你已经有视频,需要先想清楚每个镜头要什么声音,再把描述写进本模型。
公开契约允许 prompt 最长 2,000 字符,最短 1 个非空字符。这个长度足够写清声源、材质、动作、距离、空间、环境、起音和尾音,也可以补充“不要音乐、不要人声”等边界条件。
duration 接受 1–30 的整数秒,省略时按 5 秒生成。短动作和 UI 反馈适合 1–3 秒,环境声和持续机械声可以用 10–30 秒覆盖完整镜头;建议先用 1–3 秒试听音色,再生成正式长度。
每次请求返回一条 WAV 音频。实测输出为 PCM 16-bit、48 kHz、单声道,常见剪辑软件和游戏引擎可以直接读取。首版不提供 MP3、Opus 等其他格式,也不支持一次请求返回多条样本;需要多个版本时分别提交请求。
不可以。Mirelo SFX 2.0 只负责音效与环境声。歌曲与纯音乐请使用 Lyria 3.5 或 MiniMax Music,单人语音与多人对白请使用语音合成模型。
一次只改一个变量:先固定时长,再逐步调整声源、材质、距离或空间描述。把“什么物体、什么材质、多远、在什么空间里”写具体,通常比堆叠“震撼、真实、电影感”更有效;不同请求之间不保证逐样本一致。
向 POST /v1/tasks 发送异步任务,model 填 mirelo-sfx-2.0,input 里传 prompt,按需传 duration。接口立即返回 taskId,可用 callback.url 接收结果,或轮询 GET /v1/tasks/:id。
按输出音频的秒数计费,时长由请求里的 duration 决定。失败任务会退回扣费;具体单价以本页实时价格为准,页面顶部价格卡和 Playground 预估使用同一口径。