Kimi K3.1 Pro 发布后,问得最多的一个问题就是:它和 Claude Opus 5.5 到底怎么选。这两个模型的官方 API 定价几乎一模一样(输入 $2 / 输出 $10 每 1M tokens),所以答案不在价格上,而在你的任务类型上。这篇文章按场景拆开讲。
先说结论
- 定价打平:Kimi K3.1 Pro 官方 $2/$10,HiAPI 上的 claude-opus-5-5 是 $2.02/$10.08(截至 2026 年 10 月)。同价位比的是能力取向,不是省钱
- 编码基本打平:Terminal-Bench 上 65.7 对 66.4,Kimi 在 SWE-Marathon 上 51.7 对 46.3 反超
- 幻觉率 Kimi 明显更低:8.3% 对 15.0%,约一半
- 深度科学推理 Opus 明显更强:第三方测试领先约 25 分
- Kimi 独有的牌:1M 上下文、即将开放完整权重(承诺 2026-11-04 前)
一个必须先说清的口径问题:网络上流传的对比数字多数来自 Moonshot 官方自测,且 Kimi 默认跑在 max effort、Opus 默认是 medium,两边火力并不完全对等。多个第三方来源的综合判断是一致的:局部反超、总体未全面领先。下面的分析都建立在这个共识上。
背景:AA 榜冲到第 4,K3.1 升级了什么
Artificial Analysis 的智能指数上,Kimi K3.1 Pro 拿到 55 分,排第 4。前三名是 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。前代 K3 是 44 分,也就是说这一代一口气追了 11 分。等完整权重按计划发布后,它会是 AA 榜上分数最高的开放权重模型。
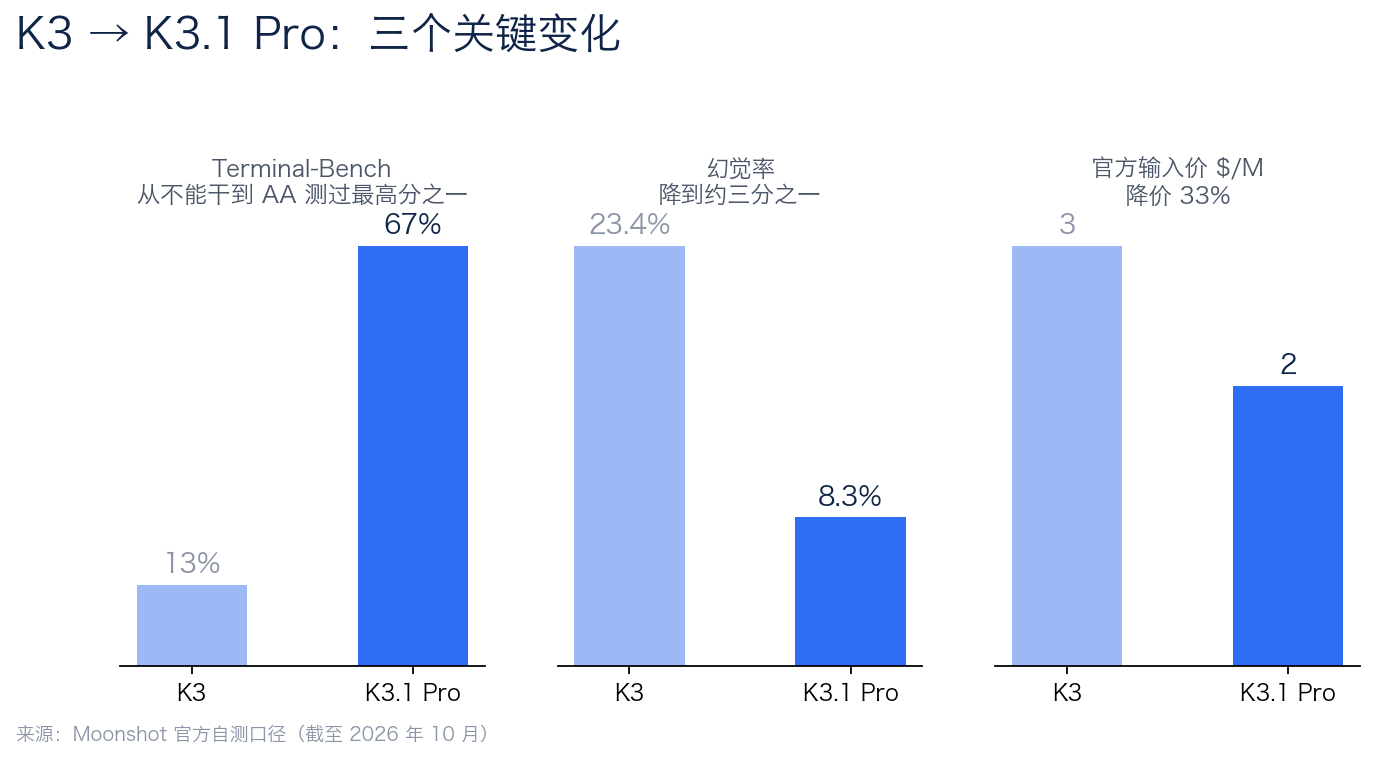
K3.1 Pro 是 K3 的后训练升级版,架构没变:2.8T 总参数、104B 激活的 MoE,1M 上下文,支持文本和图片输入(不含音视频)。升级集中在后训练上,变化最大的是三块:
- Agentic 编码跳变:Terminal-Bench 从 13% 提到 67%,这是从「不能干」到「AA 在该基准上测过的最高分」的跨度
- 幻觉率砍到三分之一:23.4% 降到 8.3%
- 官方降价 33%:从 $3/$15 降到 $2/$10,速度约翻倍
中文社区对这次发布的反应很直接:36kr 报道上线当天额度「10 分钟烧光」。热度是真的,但我们更关心它在你日常工作流里能替掉哪个模型。
场景对比
编码和 Agent 任务:基本打平,取向不同
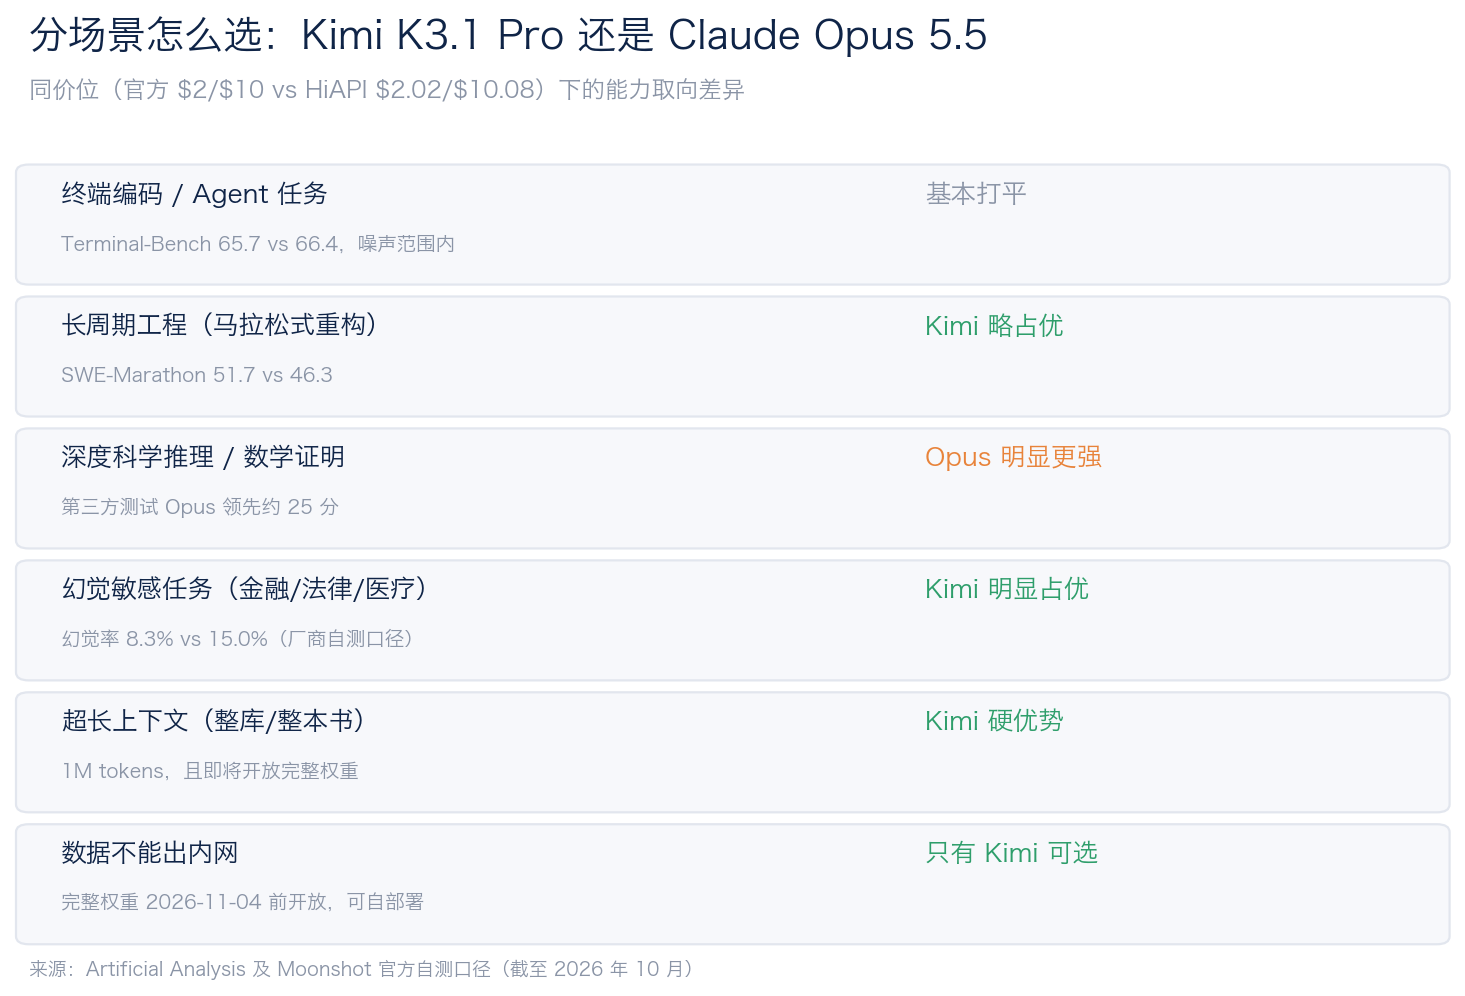
这是最让人意外的部分。Terminal-Bench 4.0 上 K3.1 Pro 拿到 65.7%(Moonshot 官方自测口径),Opus 5.5 是 66.4%,差距在噪声范围内。更长周期的 SWE-Marathon 上 Kimi 51.7 对 46.3 反超。AA 的 Agentic 细分榜 GDPval-AA 上,K3.1 Pro 排第 3(1,846 Elo)。
翻译成人话:如果你的 Agent 任务是「在终端里多步骤干活」或者「马拉松式的大型重构」,两个模型都能扛,Kimi 在长任务上还略有优势。如果你是 Claude Code 的重度用户,可以参考我们之前的实测:把 Claude Code 接到 hiapi 的 API Key 上跑了一圈,那套流程现在多一个候选模型。
实际建议:这类场景不要信跑分,拿你仓库里真实的 20 个任务各跑一遍,谁的通过率高用谁。两个模型同价位,双模型灰度的成本几乎为零。
深度推理:Opus 仍然明显更强
这是 Opus 5.5 守住的基本盘。第三方测试中,深度科学推理 Opus 领先约 25 分;综合智能指数 Opus 58 对 55 领先 3 分。如果你的工作是数学证明、复杂科学分析、多跳逻辑推导,这一档的差距是真实存在的,K3.1 Pro 暂时追不上。
幻觉率:Kimi 约为 Opus 的一半
8.3% 对 15.0%(Moonshot 官方自测口径),这个差距在需要事实准确性的场景里是质变。金融研究、法律文本摘要、医疗问答、客服知识库,这类「说错一个字就要返工」的任务,低幻觉率比跑分高几分值钱得多。这也是 K3.1 相对 K3 进步最大的单项之一(23.4% → 8.3%)。
长上下文:Kimi 的 1M 是硬优势
两个模型都有长上下文能力,但 Kimi K3.1 Pro 的 1M tokens 在喂整本书、整个代码库、长财报的场景下更从容。更关键的是它即将开放完整权重:对数据不能出内网的团队,「开源 + 1M 上下文 + 旗舰级能力」这个组合,Opus 5.5 给不了。
价格与速度
先把价格摆清楚(截至 2026 年 10 月):
| 模型 | 官方输入 | 官方输出 | HiAPI 平台价 |
|---|---|---|---|
| Kimi K3.1 Pro | $2/M | $10/M | [$2.1548/$11.2714(截至 2026-10):平台定价,上线后核 /api/pricing 回填] |
| claude-opus-5-5 | — | — | $2.02 / $10.08(缓存读 $0.10/M) |
K3.1 Pro 官方还有缓存命中价 $0.20/M,以及 Highspeed 变体($4/$20,速度快 2-3 倍),适合延迟敏感的在线场景。前代 Kimi K3 在 HiAPI 上是 $2.1548/$11.2714,供参考。
速度上各来源口径在 27-80 tokens/秒之间,属于偏慢档,但比 K3 快了一倍。AA 的每任务成本测算里,K3.1 Pro 是 $1.98,和 K3 持平,考虑到能力提升,性价比是改善的。
一句话总结价格段:这不是「便宜的挑战者打贵的标杆」,而是同价位下用更低的幻觉率和更长的上下文换更弱的深度推理。
怎么选:按场景给答案
选 Kimi K3.1 Pro,如果:
- 你的任务是 Agentic 编码、终端操作、长周期软件工程
- 你极度在意幻觉率(金融、法律、医疗、知识库问答)
- 你需要 1M 上下文处理整本资料
- 你需要自托管(等权重开放)或要求开放权重可审计
选 Claude Opus 5.5,如果:
- 你的核心是深度科学推理、复杂数学、多跳逻辑
- 你要的是经过更长时间检验的成熟度
- 你的工作流已经深度绑定 Anthropic 生态
两头都占的务实做法:同价位意味着可以按任务路由,推理类任务走 Opus,编码和事实问答走 Kimi。想了解 Opus 5.5 的完整能力边界,看它的模型详情页。
常见问题
Kimi K3.1 Pro 和 Claude Opus 5.5 哪个写代码更好?
基本打平。Terminal-Bench 4.0 上 65.7 对 66.4(Moonshot 官方自测),更长周期的 SWE-Marathon 上 Kimi 51.7 对 46.3 反超。真正该做的是拿你自己的任务集各跑一遍,不要只看榜单。
Kimi K3.1 Pro 幻觉率真的比 Opus 5.5 低吗?
按 Moonshot 官方自测口径,8.3% 对 15.0%,约为一半。这个单项的第三方佐证相对充分,属于 K3.1 最站得住的优势。但要注意自测口径下 Kimi 跑在 max effort,实际部署时的 effort 设置会影响表现。
Kimi K3.1 Pro 上下文窗口多大?
1M tokens,文本和图片输入。喂整本资料、整个代码库是它的强项。Opus 5.5 的长上下文能力也不错,但量级上 Kimi 更宽裕。
Kimi K3.1 Pro 会开放权重吗?
Moonshot 已承诺 2026-11-04 前开放完整权重。兑现后它将是 AA 榜上分数最高的开放权重模型。对需要私有化部署的团队,这是选它的硬性理由。
Kimi K3.1 Pro API 多少钱?
官方定价 $2/输入、$10/输出(每 1M tokens),缓存命中 $0.20,另有 Highspeed 变体 $4/$20(快 2-3 倍)。HiAPI 平台定价 [$2.1548/$11.2714(截至 2026-10):平台定价,上线后核 /api/pricing 回填]。
同样的预算,两个模型怎么搭配用最划算?
按任务路由:深度推理走 Opus 5.5,编码、事实问答、长文档走 Kimi。两者单价几乎相同,路由的额外成本主要是维护两套调用的工程量。
关键结论
Kimi K3.1 Pro 和 Claude Opus 5.5 是同价位的两个不同答案。Kimi 拿低幻觉率、1M 上下文、Agentic 编码和即将到来的开放权重换掉了 Opus 的深度推理优势。没有任何一个模型在所有场景都更好,第三方共识也是局部反超而非全面领先。按你的任务类型路由,或者先用真实任务集实测一轮,比看任何榜单都可靠。HiAPI 上 claude-opus-5-5 已经可以开跑,kimi-k3.1-pro 上线前,可以先用 kimi-k3 把流程跑通。